En este artículo
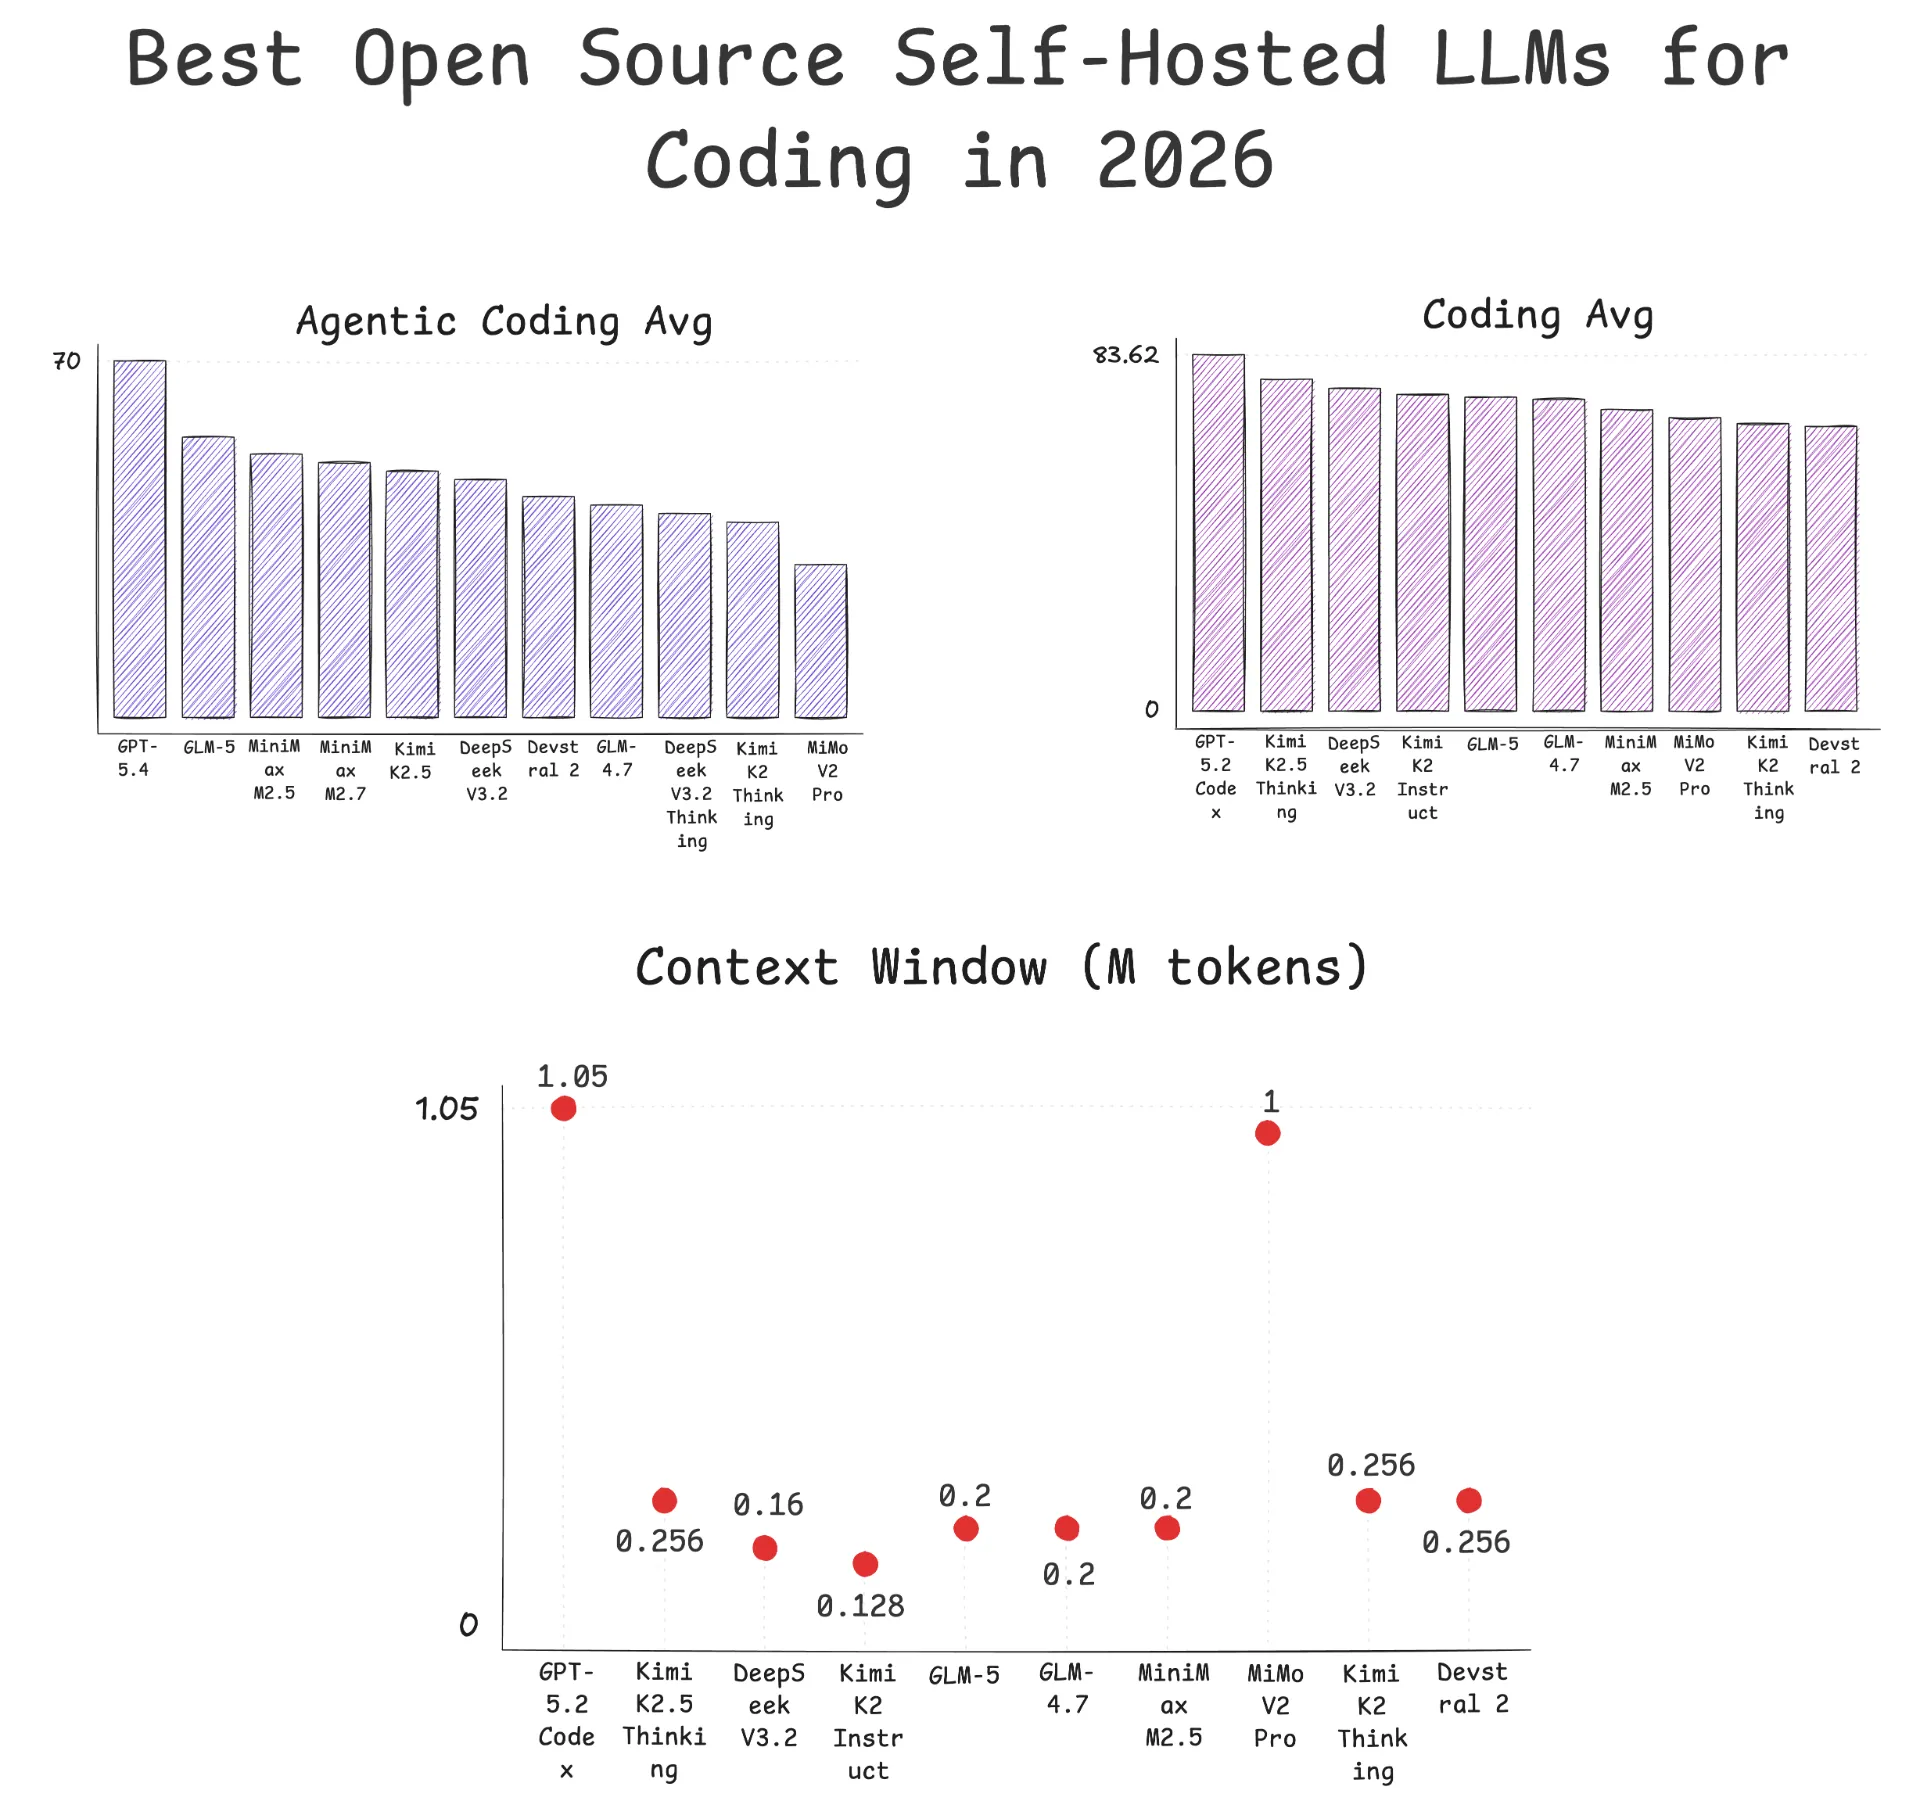
Elegir un modelo para programar era antes una decisión que tomabas una vez al año. El panorama de pesos abiertos se mueve ahora tan rápido que la respuesta correcta cambia cada pocas semanas, y para la mayoría de equipos el factor decisivo acaba siendo el hardware, no las puntuaciones de los benchmarks.
Las últimas seis semanas lo demuestran. MiMo-V2.6-Pro de Xiaomi, publicado el 21 de septiembre bajo MIT, es ahora el mejor modelo de pesos abiertos en el Artificial Analysis Intelligence Index con 46, por delante de GLM-5.3 (45) y Kimi K3 (44). DeepSeek-V4.1-Flash (10 de septiembre) encabeza sin discusión la tabla de programación agéntica de LiveBench, por encima de Claude Opus 5.5. Ninguno cabe en una sola GPU. El que sí cabe, Qwen3.8-27B, saca 34 en el mismo índice, lo que lo sigue convirtiendo en el mejor de los 142 modelos de su categoría de tamaño.
Esta guía clasifica los modelos para programar que puedes descargar de verdad a 6 de octubre de 2026, y explica qué hardware necesita cada uno. Las puntuaciones salen de Artificial Analysis (Intelligence Index v4.3.2), LiveBench y las cifras de SWE-Bench Pro y Terminal-Bench 2.1 que publica cada fabricante. Los datos de hardware salen de las fichas de los modelos, la documentación de Unsloth y las recetas de despliegue de vLLM.
Resumen
Los mejores modelos de pesos abiertos para programar (Artificial Analysis Intelligence Index v4.3.2, octubre de 2026):
- MiMo-V2.6-Pro - Índice 46, MIT, 1.02T/42B, 8x H200 - Descargar MiMo-V2.6-Pro
- GLM-5.3 - Índice 45, licencia propia, 756GB de pesos en FP8 - Descargar GLM-5.3
- Kimi K3 - Índice 44, 2.78T de parámetros, necesita al menos 8x GB300 - Descargar Kimi K3
- GLM-5.3-Flash - Índice 42, MIT, 320B/18B, 3-4x GPUs de 80GB en Q4 - Descargar GLM-5.3-Flash
- Qwen3.8-Flash-Next - Índice 40, cabe en una máquina de 128GB en 4 bits - Descargar Qwen3.8-Flash-Next
- DeepSeek-V4.1-Flash - Índice 39, MIT, n.º 1 en programación agéntica de LiveBench - Descargar DeepSeek-V4.1-Flash
- Qwen3.8-27B - Índice 34, Apache 2.0, una GPU de 24GB - Descargar Qwen3.8-27B
Una GPU: descarga Qwen3.8-27B. Es un modelo denso de 27B con licencia Apache 2.0 que necesita 16-19GB en 4 bits, y saca 34 en el índice frente a los 25 del siguiente mejor modelo pequeño.
Mac de 128GB: Qwen3.8-Flash-Next. Saca 40, igual que Qwen3.8-2.4T-A95B, los pesos abiertos que hay detrás de Qwen3.8-Max. Usa la versión de 4 bits de Atomic Chat, que deja la tabla de n-gramas en el SSD y necesita 56GB de memoria de GPU en lugar de 96-114GB.
Un servidor: GLM-5.3-Flash. Es MIT y necesita 162-210GB en 4 bits, así que te bastan tres o cuatro GPUs de 80GB en lugar de ocho.
Herramientas de self-hosting: Ollama para uso local, vLLM para servir en producción, LM Studio si quieres una interfaz gráfica de escritorio.
Cuánto se acercan los pesos abiertos a los modelos propietarios
Usamos Artificial Analysis como referencia principal porque ejecuta cada modelo por su cuenta en lugar de repetir lo que dicen los fabricantes. Su Intelligence Index cambió en septiembre: la v4.3 (7 de septiembre) sustituyó Terminal-Bench 2.1 por Terminal-Bench 4.0 y cambió τ³-Banking por AutomationBench-AA, y la versión actual, v4.3.2, combina 10 evaluaciones. Las puntuaciones bajaron en general, así que las cifras de artículos anteriores (incluida la versión anterior de este) no son comparables.
En la escala actual, Claude Opus 5.5 lidera en general con 58. El mejor modelo de pesos abiertos, MiMo-V2.6-Pro, saca 46. La columna de hardware es la configuración más pequeña capaz de alojar los pesos, calculada a partir de la ficha, la receta de vLLM o la guía de Unsloth de cada modelo, sin contar el margen para la caché KV.
| Modelo | Parámetros (activos) | Licencia | Índice AA | Configuración práctica mínima |
|---|---|---|---|---|
| Claude Opus 5.5 (propietario) | - | - | 58 | Solo API |
| MiMo-V2.6-Pro | 1.02T (42B) | MIT | 46 | 8x H200 (~574GB, casi todo MXFP4) |
| GLM-5.3 | 744B (40B) | GLM-5.3 License | 45 | 8x H200 (756GB FP8) |
| Kimi K3 | 2.78T (104B) | Kimi K3 License | 44 | 8x GB300 o 8x MI355X (1.56TB MXFP4) |
| GLM-5.3-Flash | 320B (18B) | MIT | 42 | 3-4x GPUs de 80GB en 4 bits (162-210GB) |
| Qwen3.8-Max (2.4T-A95B) | 2.4T (95B) | Qwen3.8-Max License | 40 | 8x B300 en NVFP4 (1.32TiB) |
| Qwen3.8-Flash-Next | 125B (6B) + tabla de n-gramas de 51B | Qwen Community License | 40 | Máquina de 128GB (56GB en memoria de GPU en 4 bits, tabla de n-gramas en el SSD) |
| DeepSeek-V4.1-Flash | 552B + 196B Engram (16B) | MIT | 39 | 4x H200 con Engram en la CPU (~511GB) |
| MiMo-V2.6-Flash | 309B (15B) | MIT | 38 | 4x H200 (~178GB, casi todo MXFP4) |
| DeepSeek-V4-Pro-0813 | 1.6T (49B) | MIT | 36 | 8x H200 (893GB) |
| Qwen3.8-27B | 27B denso | Apache 2.0 | 34 | Una GPU de 24GB (16-19GB en 4 bits) |
| MiniMax M3 | 428B (23B) | MiniMax Community License | 29 | 4x H100 en 4 bits (213-270GB) |
Modelos que caben en una GPU o en una máquina de 128GB
Si tu “servidor” es un portátil o un Mac de escritorio por debajo de un Ultra, el techo lo pone Apple: el M5 Max llega como máximo a 128GB de memoria unificada, tanto en el MacBook Pro como en el Mac Studio. Ahí tienen que caber los pesos y la caché KV, y por defecto macOS solo deja que la GPU use alrededor del 75%, unos 96GB. Es el mismo índice, así que estas cifras se pueden comparar directamente con la tabla de arriba.
| Modelo | Parámetros (activos) | Memoria en ~4 bits | Índice AA |
|---|---|---|---|
| Qwen3.8-Flash-Next | 125B (6B) + tabla de n-gramas | 96-114GB (56GB con la tabla en el SSD) | 40 |
| Qwen3.8-27B | 27B denso + visión | 16-19GB | 34 |
| Qwen3.6-27B | 27.8B denso | 18GB | 21 |
| Muse Glimmer 30B | 29.6B denso (incl. visión) | 17GB | 17 |
| Gemma 4 26B-A4B | 26B (4B) | 14-17GB | 17 (est.) |
| Gemma 4 31B | 30.7B denso | 17-20GB | 15 |
| Nemotron 3.5 Lightning | 31.6B (3.6B) | 21-25.5GB | 13 |
| Nemotron 3 Super 120B-A12B | 120.6B (12.7B) | 64-72GB | 13 |
| gpt-oss-120b (high) | 117B (5.1B) | ~63GB | 12 |
| Qwen3-Coder-Next | 79.7B (3B) | 46GB | 9 |
En un portátil no gana el más grande, gana el más nuevo. Qwen3.8-27B supera por más de 20 puntos a todos los modelos de la clase de 120B que caben, y lo único que tiene por encima en una máquina de 128GB es Qwen3.8-Flash-Next. Su perseguidor en la categoría pequeña es ahora K2 Horizon MoVA 36B-A4B (Apache 2.0), con 25. GLM-5.3-Flash también entra a duras penas en 128GB con la cuantización de 2 bits de Unsloth (un archivo de 109GB), a costa de una pérdida de calidad real.
SWE-Bench Pro y Terminal-Bench 2.1
El Intelligence Index mide la capacidad general. Para código en concreto, SWE-Bench Pro (arreglar issues reales en repos reales) y Terminal-Bench 2.1 (tareas agénticas en una shell) son los que más modelos de pesos abiertos cubren. Son cifras que publica cada fabricante en la ficha de su modelo, contrastadas con las tablas de SWE-Bench Pro y Terminal-Bench 2.1 en Hugging Face, y ordenadas por Terminal-Bench.
| Modelo | Lanzamiento | SWE-Bench Pro (v1) | Terminal-Bench 2.1 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | sep 2026 | No publicado | 90.6 |
| MiMo-V2.6-Pro | sep 2026 | No publicado | 89.9 |
| Kimi K3 | jul 2026 | No publicado | 88.3 |
| GLM-5.3 | ago 2026 | No publicado | 88.2 |
| DeepSeek-V4-Pro-0813 | ago 2026 | 55.4 (preview de abril) | 87.9 |
| MiMo-V2.6-Flash | sep 2026 | No publicado | 87.6 |
| Qwen3.8-Max | ago 2026 | 67.7 | 86.6 |
| Ornith-1.5-397B | ago 2026 | 65.1 | 86.1 |
| Tencent Hy4-preview | ago 2026 | 65.7 | 85.4 |
| GLM-5.3-Flash | ago 2026 | No publicado | 84.3 |
| Nex-N2.5-Pro | sep 2026 | 61.2 | 82.7 |
| GLM-5.2 | jun 2026 | 62.1 | 81.0 (Terminus-2) |
| dots3-note-prev | ago 2026 | 61.0 | 75.1 |
| Qwen3.8-27B | ago 2026 | 61.7 | 73.0 |
| Poolside Laguna-S-2.1 | jul 2026 | 59.4 | 70.2 |
| MiniMax M3 | jun 2026 | 59.0 | 66.0 |
| Muse Glimmer 30B | ago 2026 | 51.2 | 51.7 |
| Qwen3.8-Flash-Next | ago 2026 | 62.5 | No publicado |
La parte alta de la columna de Terminal-Bench ya es de los pesos abiertos. El 90.6 de DeepSeek-V4.1-Flash queda por encima del 88.8 de GPT-5.6 Sol (cifra de OpenAI) y de la ejecución propia de Artificial Analysis con Claude Opus 5 (89.1), aunque por debajo de Claude Fable 5.1 (91.4 en la ejecución de AA). En SWE-Bench Pro, Qwen3.8-Max sigue liderando entre los pesos abiertos con 67.7, y la cifra más útil es el 61.7 de Qwen3.8-27B con una fracción del tamaño.
Tres advertencias antes de comparar esto con cualquier otra cosa. Todas estas cifras las ejecuta el propio fabricante, y cada laboratorio usa su propio scaffolding. El leaderboard SEAL estandarizado de Scale llega como máximo a 61.5 (Muse Spark 1.1) y no incluye ninguno de estos modelos. SWE-Bench Pro pasó a un dataset V2 el 22 de septiembre, así que estas puntuaciones de v1 no cuadrarán con los envíos nuevos. Además, las puntuaciones de SWE-Bench Pro de Qwen salen de su propia versión corregida de las tareas de v1. Y la frontera ya se ha movido a Terminal-Bench 4.0, donde Claude Opus 5.5 encabeza el leaderboard de tbench.ai con 64.8 y la única entrada de pesos abiertos hasta ahora es GLM-5.3, con 41.8.
Lo que aporta LiveBench
LiveBench es la comprobación cruzada que tiene en cuenta la contaminación de datos, y ya ha puntuado la mayoría de los lanzamientos de agosto y septiembre (MiMo-V2.6 todavía no). DeepSeek-V4.1-Flash encabeza toda la tabla de programación agéntica con 77.27, por encima de Claude Opus 5.5, con 71.72. Entre el resto de pesos abiertos, DeepSeek-V4-Flash-Vision-Exp saca 65.10 en programación agéntica, Qwen3.8-Max 64.65, Kimi K3 62.17, Qwen3.8-Flash-Next 61.62, Qwen3.8-27B 61.36 y GLM-5.3 60.91. En programación a secas, Kimi K3 sigue siendo el mejor modelo base de pesos abiertos, con 81.45.
Los mejores LLMs de código abierto para programar
La lista de abajo es una selección de modelos de pesos abiertos que puedes descargar hoy, más o menos en el orden del índice de Artificial Analysis. La mayoría de los cinco primeros necesitan hardware de centro de datos, así que lee las notas de despliegue antes de hacer planes con ellos. Para una sola GPU o un Mac de 128GB, salta directamente a Qwen3.8-27B y Qwen3.8-Flash-Next.
1. MiMo-V2.6-Pro y MiMo-V2.6-Flash (Xiaomi) - el mejor de pesos abiertos
Captura: huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-MOPD, octubre de 2026.
Xiaomi publicó MiMo-V2.6-Pro y MiMo-V2.6-Flash el 21 de septiembre de 2026 con una licencia MIT tal cual, sin umbrales de ingresos. Cada uno viene en dos versiones: los repos -RL del día del lanzamiento y los repos -MOPD mejorados, publicados el 27 de septiembre. Los dos aceptan texto, imagen, vídeo y audio como entrada, con un contexto de 1M de tokens, hasta 128K tokens de salida y una combinación de atención de ventana deslizante y atención global, más un drafter de predicción multitoken para decodificar más rápido.
El Pro es un MoE de 1.02T de parámetros con 42B activos (384 expertos, 8 activos por token). Sus pesos, casi todos en MXFP4 de 4 bits, suman unos 574GB, y la receta de vLLM pide al menos 680GB de VRAM, así que el mínimo son ocho H200. Saca 46 en el Intelligence Index, 89.9 en Terminal-Bench 2.1 y 71.9 en DeepSWE. El Flash tiene 309B con 15B activos, unos 178GB de pesos, y funciona en cuatro H200. Saca 38 en el índice y 87.6 en Terminal-Bench 2.1. Ninguno de los dos publica SWE-Bench Pro ni SWE-Bench Verified, y Unsloth todavía no tiene guía para ellos.
Sustituyen al MiMo-V2.5-Pro de abril, que Artificial Analysis marca ahora como obsoleto, con 26.
2. GLM-5.3 y GLM-5.3-Flash (Z.AI)
Captura: huggingface.co/zai-org/GLM-5.3, octubre de 2026.
Z.AI anunció GLM-5.3 el 14 de agosto y publicó los pesos en Hugging Face el 28 de agosto, después de retenerlos dos semanas para evaluaciones de seguridad. El modelo base es el mismo de GLM-5.2 (744B en total, 40B activos); toda la mejora viene del post-entrenamiento. Terminal-Bench 3.0 pasa de 4.6 a 28.3, DeepSWE v1.1 de 46.2 a 66.9, y la ficha reporta 88.2 en Terminal-Bench 2.1. Tambien saca un 84.5% en CyberGym, y Z.AI dice que con él encontró 2436 vulnerabilidades en 269 proyectos reales.
El repo por defecto está en FP8 nativo: 141 shards de safetensors, 756GB, que caben en ocho H200 pero no en un nodo de 8x80GB H100 (también hay una copia en BF16 de unos 1.5TB). Tiene 78 capas, 256 expertos enrutados con 8 activos, un contexto de 1M de tokens y razonamiento en tres niveles que no se puede desactivar. La GLM-5.3 License es parecida a MIT, salvo que los operadores de modelo como servicio con más de 10.000 millones de dólares de ingresos tienen que pasar antes una revisión de seguridad de Z.AI.
GLM-5.3-Flash es el que la mayoría de equipos puede desplegar. Publicado el 26 de agosto bajo MIT, es un MoE de 320B con 18B activos, el primer modelo GLM-5 multimodal de forma nativa, con un contexto de 1M de tokens. Su combinación de atención lineal y dispersa le da una caché KV 4.44x más pequeña y unas 3x menos de cómputo de atención que GLM-5.3. Saca 42 en el índice, 84.3 en Terminal-Bench 2.1 y 63.4 en DeepSWE, a unos $0.25 por tarea en la ejecución de Artificial Analysis. Los pesos nativos en FP8 (328GB) necesitan un nodo de 8x80GB, pero una versión de 4 bits de 162-210GB (la UD-Q4_K_XL de Unsloth ocupa 200GB) cabe en tres o cuatro GPUs de 80GB o en un Mac de 256GB, y la cuantización de 2 bits de Unsloth necesita unos 115GB. La rama principal de llama.cpp incorporó el soporte el 30 de septiembre.
3. Kimi K3 (Moonshot AI)
Captura: huggingface.co/moonshotai/Kimi-K3, octubre de 2026.
Moonshot anunció Kimi K3 el 16 de julio y publicó los pesos el 27 de julio. Con 2.78T de parámetros en total y 104B activos, es el modelo de pesos abiertos más grande publicado hasta ahora: 896 expertos con 16 activos por token, 93 capas (69 de Kimi Delta Attention más 24 de Gated MLA), un codificador de visión MoonViT-V2 y un contexto de 1M de tokens.
Los pesos vienen en MXFP4 de forma nativa gracias al entrenamiento consciente de la cuantización, así que la descarga de 1.56TB ya es la versión compacta, y la receta de vLLM pide al menos ocho GPUs GB300 o MI355X, con varios nodos para tráfico de producción. Unsloth sí publica GGUFs, pero su cuantización recomendada de 1 bit (UD-IQ1_S) sigue ocupando 594GB, e incluso el archivo más pequeño (UD-Q1_0) pesa 466GB. La Kimi K3 License permite el self-hosting y el fine-tuning y deja exento el uso interno, pero los operadores de modelo como servicio con más de $20M de ingresos necesitan un acuerdo aparte, y los productos con más de 100M de usuarios mensuales o $20M de ingresos mensuales tienen que mostrar “Kimi K3” en la interfaz.
Moonshot reporta 88.3 en Terminal-Bench 2.1, 81.2 en FrontierSWE y 67.5 en DeepSWE, sin cifra de SWE-Bench Pro. Sigue siendo el mejor modelo base de pesos abiertos en la categoría de programación de LiveBench (81.45), y saca 44 en el índice, ahora tercero entre los pesos abiertos. El precio de la API es de $3 por millón de tokens de entrada ($0.30 en caché) y $15 por millón de salida.
4. Qwen3.8-Max (Alibaba)
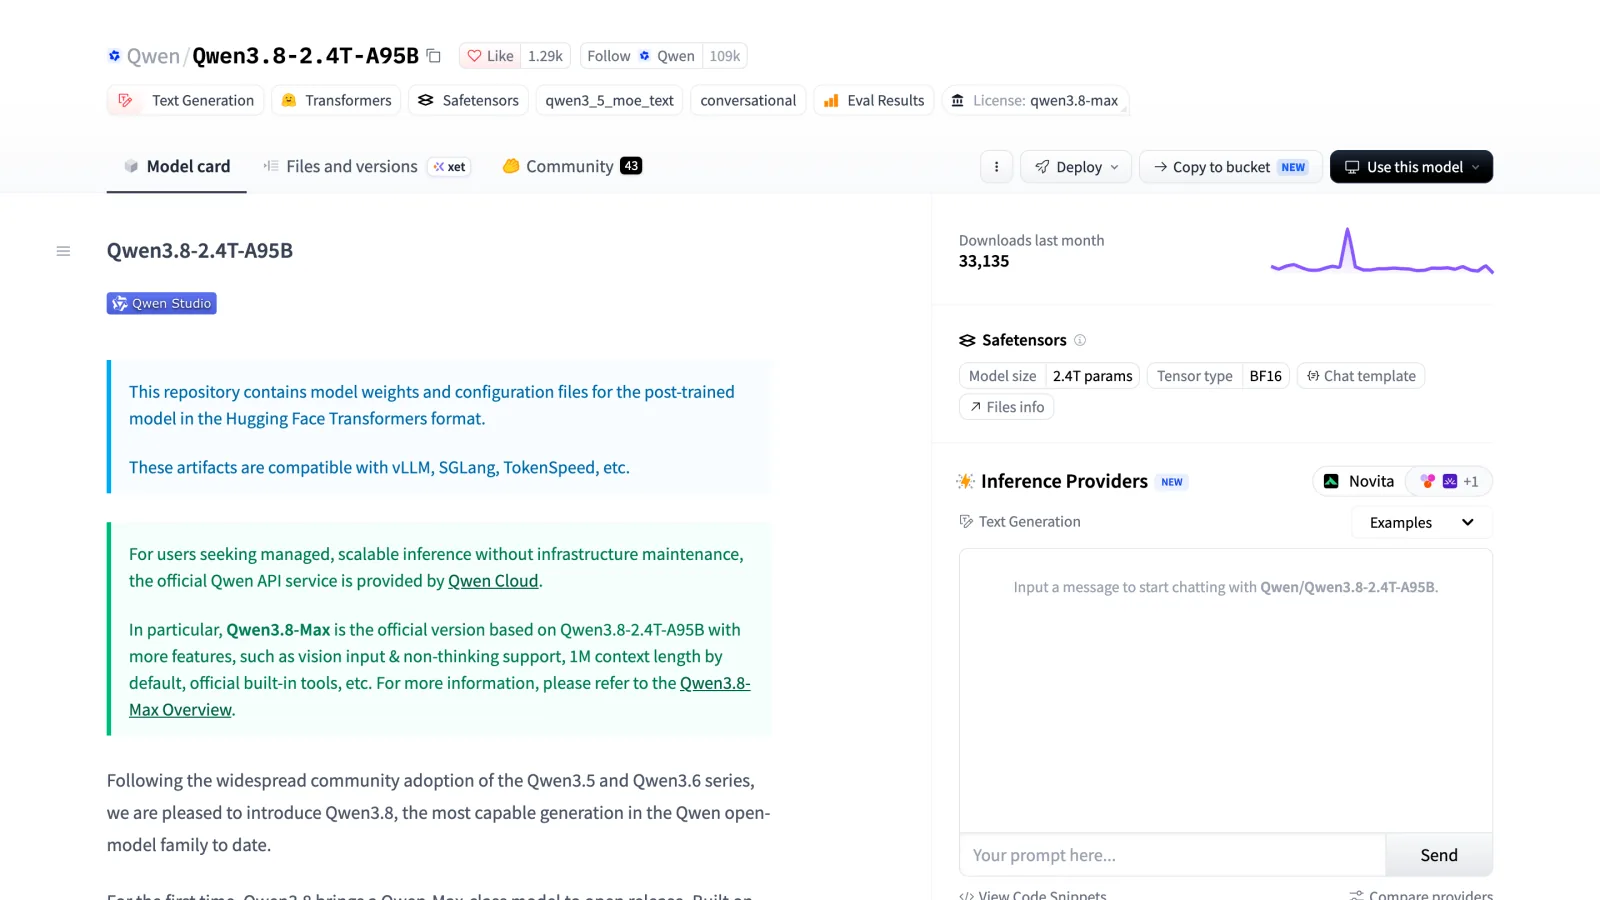
Captura: huggingface.co/Qwen/Qwen3.8-2.4T-A95B, octubre de 2026.
Alibaba anunció Qwen3.8-Max el 3 de agosto y publicó los pesos como Qwen3.8-2.4T-A95B el 12 de agosto, la primera vez que se abren los pesos de un modelo de la clase Qwen-Max. Es un MoE de 2.4T con 95B activos (512 expertos, 10 enrutados más 1 compartido por token), un contexto de 262K ampliable a cerca de 1M y razonamiento siempre activo que puedes regular con reasoning_effort (xhigh, medium o low).
Es el modelo de pesos abiertos más fuerte de los que publican SWE-Bench Pro, con 67.7, y saca 86.6 en Terminal-Bench 2.1. Dos advertencias. Los pesos abiertos son solo de texto y no son el modelo alojado: la actualización Qwen3.8-Max-0902, disponible solo por API, saca 45 en el índice, mientras que los pesos abiertos sacan 40. Y la licencia es propia: exige atribución por encima de 100M de usuarios mensuales o $20M de ingresos mensuales, y además pide una licencia aparte para negocios de modelo como servicio, de programación con IA o de asistentes de oficina con más de $50M de ingresos al año, contando las filiales. Los pesos en BF16 ocupan unos 4.9TB. La receta de vLLM ejecuta la versión NVFP4 (1.32TiB) en ocho B300, o la versión FP8 en 16 B300 o 32 H200.
5. DeepSeek-V4.1-Flash y V4-Pro (DeepSeek)
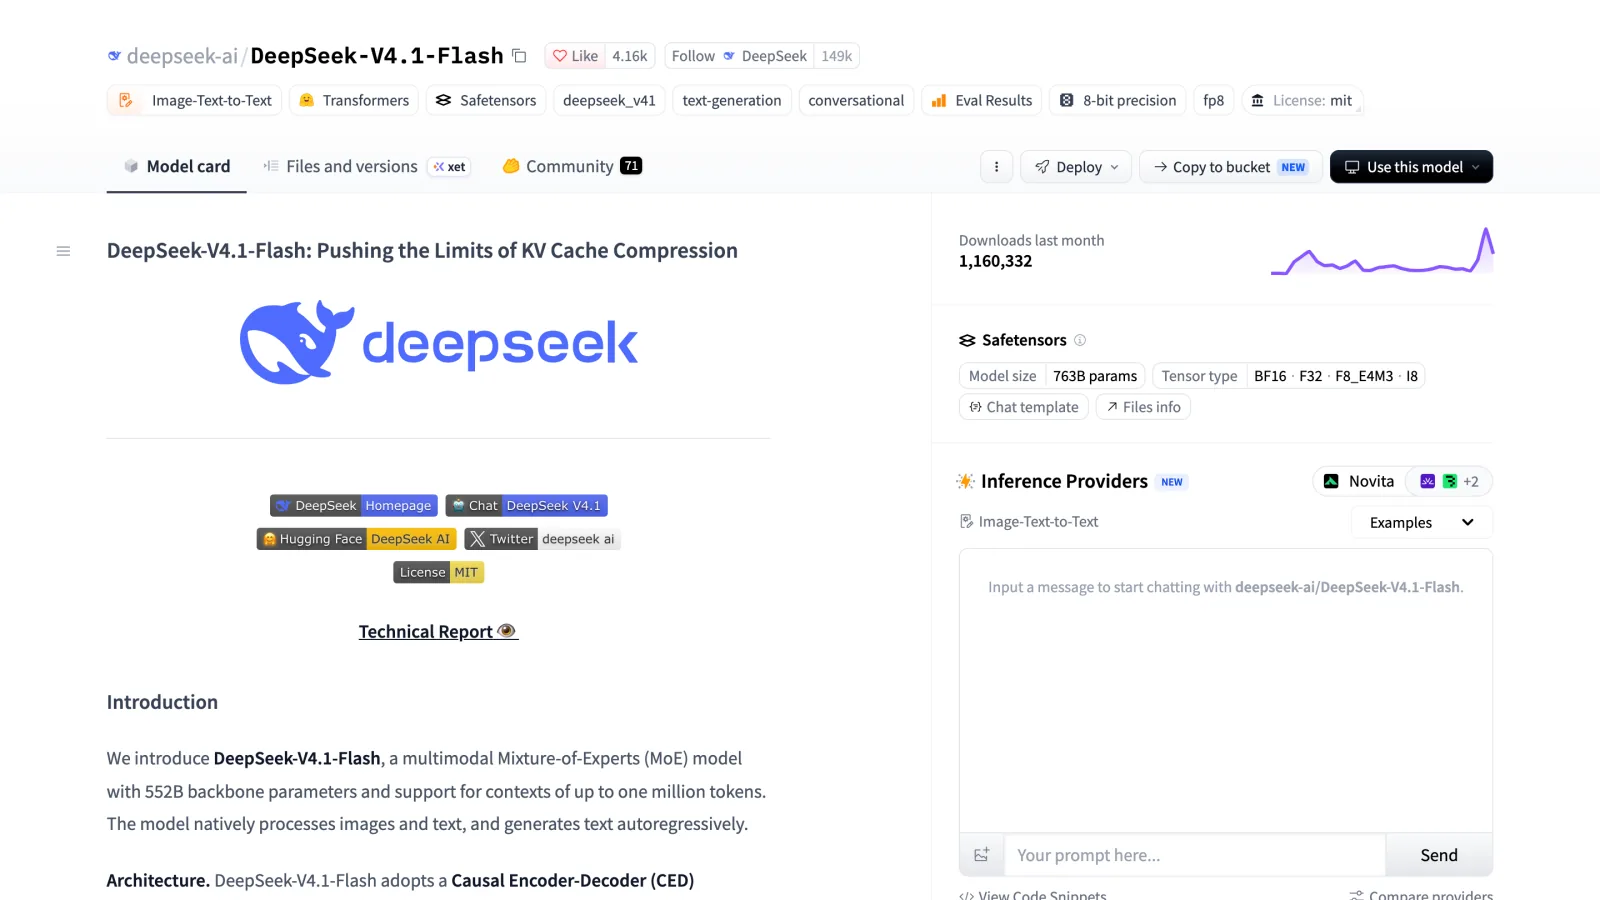
Captura: huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash, octubre de 2026.
DeepSeek-V4.1-Flash (10 de septiembre, MIT) es el diseño más raro de la lista. Es un modelo encoder-decoder con un backbone de 552B más 196B de memoria “Engram” que puede quedarse en la RAM de la CPU, 384 expertos con 6 activos, y 8B de parámetros activos durante el prefill pero 16B durante el decode. Tiene un contexto de 1M de tokens y 384K tokens de salida. DeepSeek reporta 90.6 en Terminal-Bench 2.1 (88.0 con el harness de Claude Code) y 74.2 en DeepSWE, las puntuaciones más altas entre los pesos abiertos en ambos, y LiveBench lo pone por su cuenta en el n.º 1 de programación agéntica. Saca 39 en el índice. Los pesos ocupan unos 511GB, y la receta de vLLM lo ejecuta en ocho H200, o en cuatro si llevas Engram a la CPU. Unsloth aún no tiene GGUF, y el soporte en llama.cpp sigue en revisión.
DeepSeek-V4-Pro-0813 (13 de agosto, MIT) tiene 1.6T en total con 49B activos, un contexto de 1M y tres niveles de esfuerzo, y la API de DeepSeek ya habla de forma nativa la Responses API de OpenAI. Su ficha reporta 87.9 en Terminal-Bench 2.1 y 62.7 en DeepSWE, y saca 36 en el índice. Los tan citados 80.6 en SWE-Bench Verified y 55.4 en SWE-Bench Pro vienen de la preview de abril, no de esta versión. Los pesos oficiales ya vienen con los expertos en FP4 más FP8, 893GB en total, así que el mínimo son ocho H200. En la API de DeepSeek, V4-Flash y V4-Flash-Vision-Exp se retiraron el 10 de septiembre y sus nombres ahora apuntan a V4.1-Flash. Si prefieres quedarte con el anterior V4-Flash-0731, de 284B, cabe en una máquina de 128GB en 3 bits, como explica nuestra guía de herramientas y modelos LLM locales.
6. Qwen3.8-Flash-Next (Alibaba) - el mejor para una máquina de 128GB
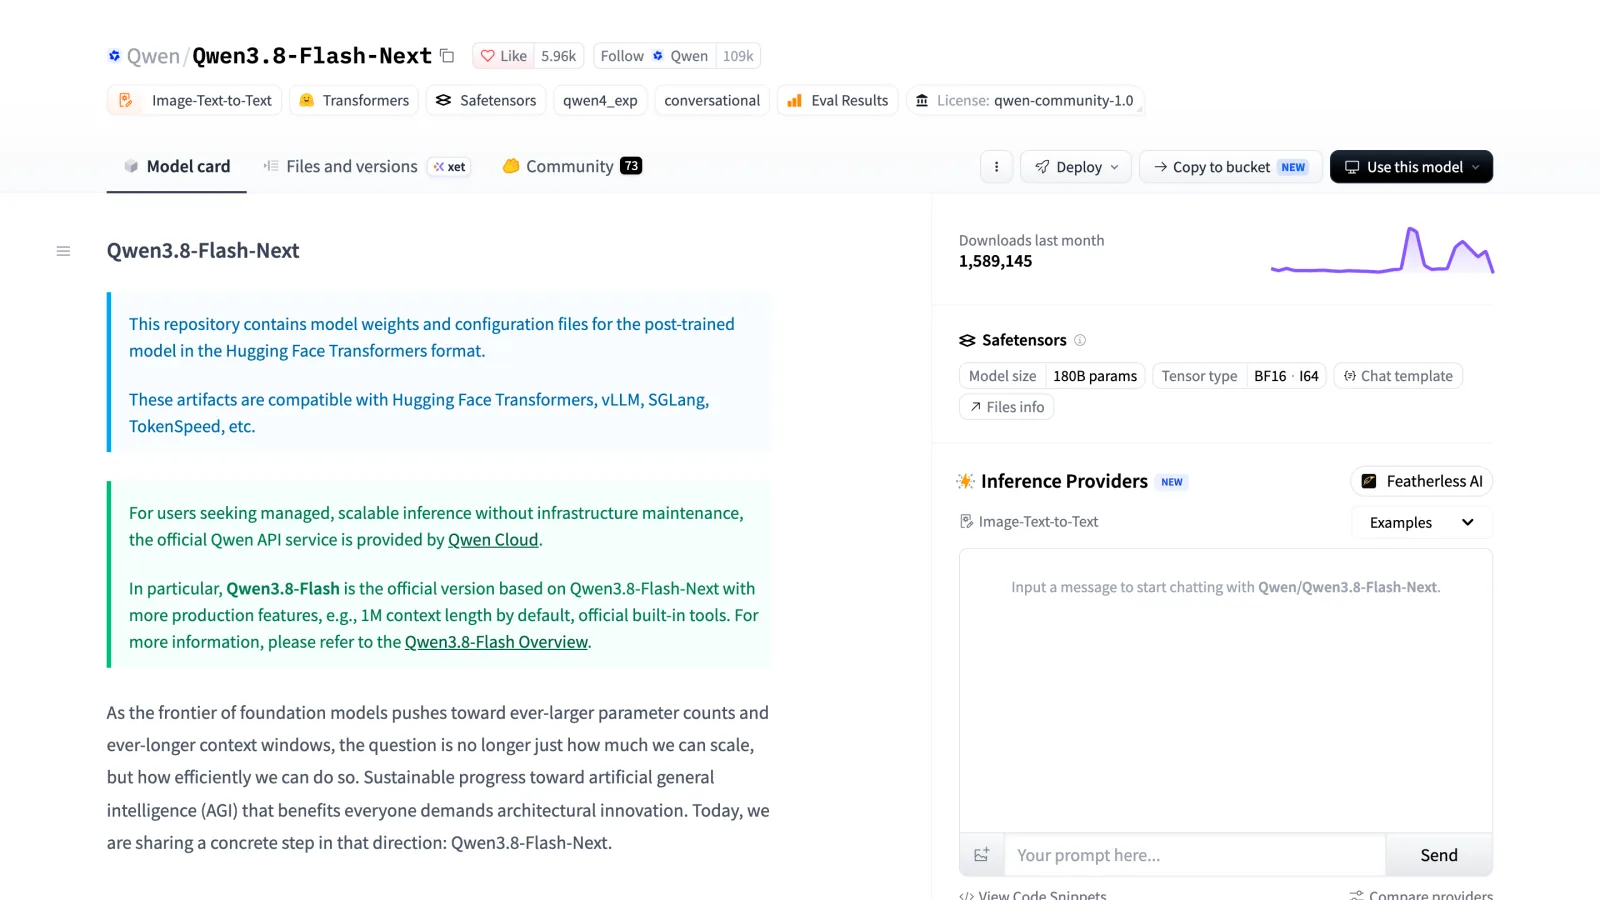
Captura: huggingface.co/Qwen/Qwen3.8-Flash-Next, octubre de 2026.
Qwen3.8-Flash-Next (26 de agosto) es el adelanto de Alibaba de la arquitectura Qwen4: 125B de parámetros con 6B activos, más una tabla de embeddings de n-gramas de 51B que se puede mover a la RAM o al SSD, Gated DeltaNet con Qwen Sparse Attention, entrada de imágenes nativa y un contexto de 262K ampliable a 1M. El razonamiento se puede desactivar, a diferencia de Max.
Saca 40 en el índice, igual que Qwen3.8-2.4T-A95B, los pesos abiertos que hay detrás de Qwen3.8-Max, con 62.5 en SWE-Bench Pro y 91.9 en LiveCodeBench v6. Lee antes la Qwen Community License: exige atribución por encima de 100M de usuarios mensuales o $20M de ingresos mensuales, y cualquier empresa (o filial) que tenga un negocio de modelo como servicio o de “asistente de trabajo con IA” (programación con IA o productividad de oficina) necesita una licencia aparte antes de usarlo comercialmente, sea del tamaño que sea. El uso puramente interno, sin nada expuesto a terceros, queda exento.
En un Mac, elige bien el GGUF. La guía de Unsloth pone la cuantización de 4 bits en 96-114GB, que está en el límite o por encima de los aproximadamente 96GB que macOS deja usar a la GPU en una máquina de 128GB. La versión de Atomic Chat deja en cambio la tabla de n-gramas de 38GB en el SSD, así que su cuantización de 4.27bpw solo ocupa 56GB de memoria de GPU, y queda sitio para contexto largo o un segundo modelo. Su versión de 3.84bpw incluso funciona en un Mac de 64GB, a costa de una pérdida de calidad real. La sección de configuración de más abajo explica por qué funciona y tiene los comandos.
7. Qwen3.8-27B (Alibaba) - el mejor para una sola GPU
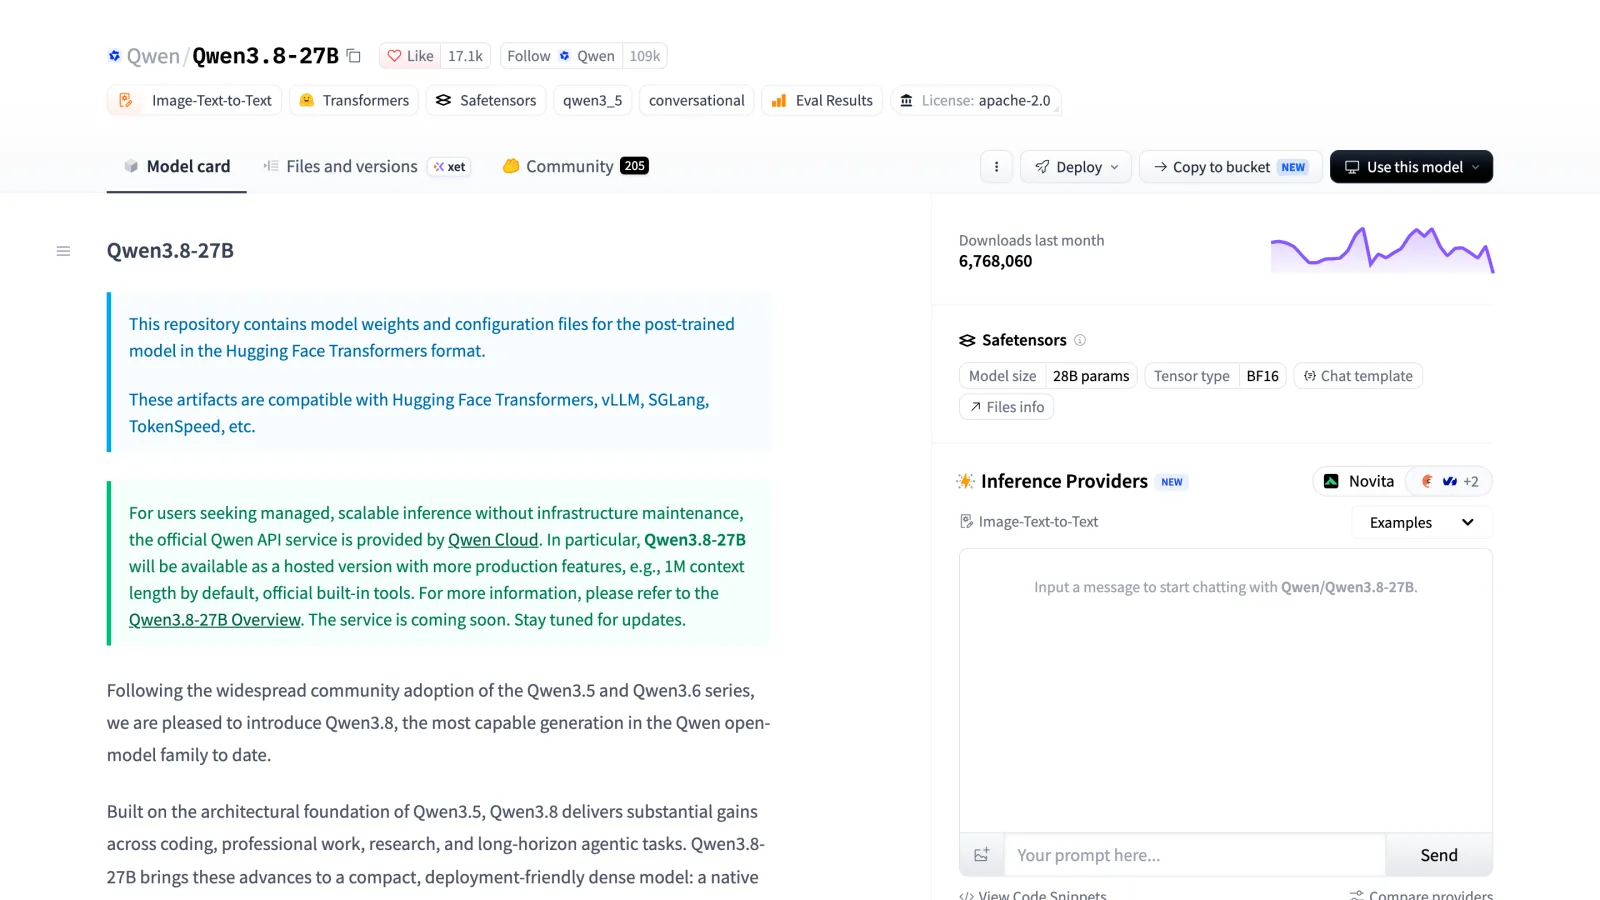
Captura: huggingface.co/Qwen/Qwen3.8-27B, octubre de 2026.
Para quien no tenga un servidor de GPUs, este es el modelo más importante de la lista. Alibaba publicó Qwen3.8-27B el 14 de agosto bajo Apache 2.0. Es un modelo denso de visión y lenguaje de 27B con 64 capas (que repiten tres bloques Gated DeltaNet y un bloque de gated attention) y un contexto de 262K ampliable a cerca de 1M.
Lo que importa son las cifras de programación: 61.7 en SWE-Bench Pro, 73.0 en Terminal-Bench 2.1, 90.3 en LiveCodeBench v6 y 42.2 en DeepSWE, más del triple que los 13.3 de Qwen3.6-27B. SWE-Bench Pro y DeepSWE se ejecutaron con el harness de Claude Code, y Terminal-Bench con Terminus. Saca 34 en el índice, el primero de los 142 modelos de su categoría de tamaño y muy por delante de Qwen3.6-27B (21).
Necesita 16-19GB en 4 bits (una sola tarjeta de 24GB como una RTX 4090, o un Mac de 24GB), unos 31GB en FP8 y 56GB en BF16, y el tag por defecto de Ollama es una descarga de 18GB. La pega de verdad es lo mucho que habla. Artificial Analysis midió 47.8 tokens/s de salida frente a 222.8 de DeepSeek-V4-Flash-0731, y tardó unas seis veces más en completar el índice. Baja el esfuerzo de razonamiento para ediciones interactivas y mantenlo alto para las ejecuciones del agente. Si prefieres un especialista en código, Qwen3-Coder-Next (80B, 3B activos, 46GB en 4 bits) es rápido, pero puntúa mucho más bajo en el índice actual (9).
8. MiniMax M3 (MiniMax)
Captura: huggingface.co/MiniMaxAI/MiniMax-M3, octubre de 2026.
MiniMax M3 salió el 1 de junio, con los pesos en Hugging Face desde el 12 de junio. Es un MoE de 428B con 23B activos, un contexto de 1M de tokens y entrada nativa de imagen y vídeo, construido en torno a MiniMax Sparse Attention (MSA), que lee cada bloque de la caché KV una sola vez. MiniMax reporta 59.0 en SWE-Bench Pro, 66.0 en Terminal-Bench 2.1 y 74.2 en MCP-Atlas, y saca 29 en el índice.
Dos cosas que conviene saber. Los GGUF de 4 bits de Unsloth necesitan 213-270GB, así que cuenta con cuatro H100, y son solo de texto con atención densa porque llama.cpp no implementa MSA. Y la MiniMax Community License es restrictiva: la concesión base es no comercial, el uso comercial exige un aviso “Built with MiniMax M3” y una notificación única a MiniMax, y los productos con más de $20M al año necesitan autorización por escrito.
9. Muse Glimmer 30B (Meta) - el mejor uso de herramientas MCP en una GPU
Captura: huggingface.co/meta-models/Muse-Glimmer-30B, octubre de 2026.
Meta Superintelligence Labs publicó Muse Glimmer el 10 de agosto: un modelo multimodal denso de 29.6B (incluido un codificador de visión de 1.8B) bajo Apache 2.0, con 52 capas y un contexto de 131K. Los pesos en BF16 ocupan unos 60GB, y las versiones K-Quant de Meta lo dejan por debajo de 20GB con una degradación del 0.2-1.0%, así que cabe en una tarjeta de 24GB.
Las cifras de la propia Meta son buenas en uso de herramientas: 75.5 en MCP Atlas frente a los 62.5 de Qwen3.6-27B, cerca de los 76.8 de GLM-5.2 con sus 744B de parámetros, además de 51.2 en SWE-Bench Pro. Los resultados independientes son más flojos. Saca 17 en el índice actual, por detrás de Qwen3.6-27B con 21, y la reseña de lanzamiento de Artificial Analysis señaló el trabajo agéntico de conocimiento como “su punto débil en relación con su categoría de tamaño”. Qwen3.8-27B, publicado cuatro días después, lo supera en todos los benchmarks que publican los dos. Lo que le queda es MCP Atlas y DFlash, un decodificador especulativo de difusión por bloques con el que Meta midió un salto de 74.9 a 233.4 tokens/s en una RTX 5090 con una salida idéntica. Funciona en Ollama, LM Studio, llama.cpp, MLX, vLLM y SGLang.
10. Nemotron 3.5 Lightning (NVIDIA) - la inferencia local más rápida
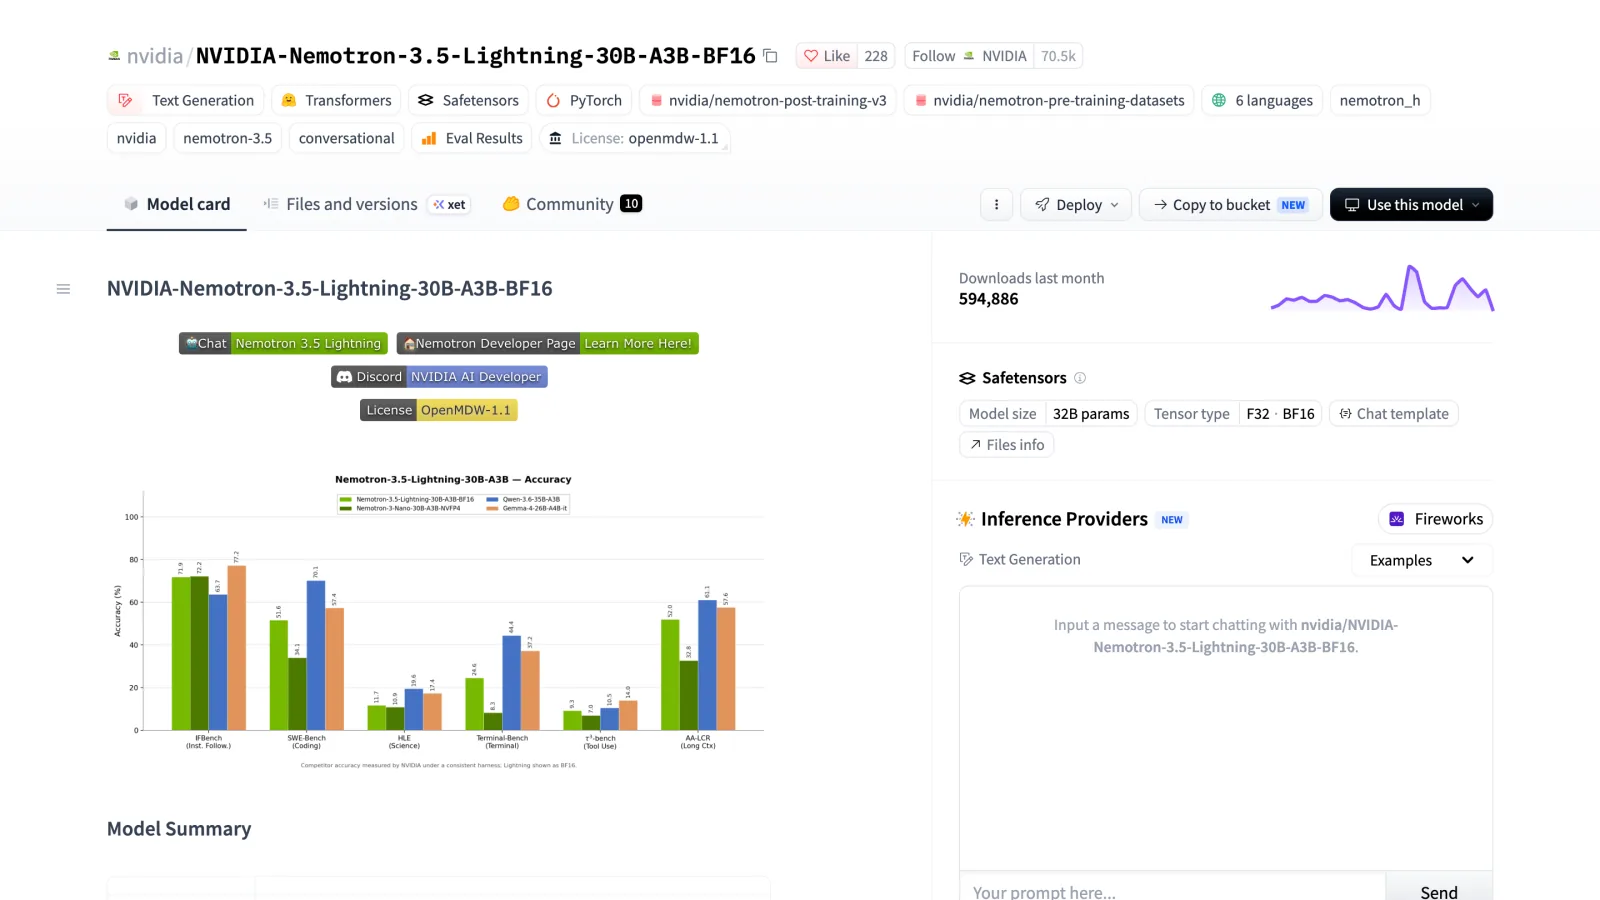
Captura: huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16, octubre de 2026.
NVIDIA lanzó Nemotron 3.5 Lightning el 11 de agosto: un híbrido de Mamba-2, MoE y atención con 31.6B de parámetros totales y 3.6B activos según el recuento de Artificial Analysis (NVIDIA redondea a 30B y 3B), destilado de Nemotron 3 Ultra, con hasta 1M de tokens de contexto. Se distribuye bajo OpenMDW-1.1, con los pesos, los datos de entrenamiento y las recetas publicados.
En capacidad no compite con Qwen3.8-27B. Saca 13 en el índice, igual que Nemotron 3 Super y por encima de gpt-oss-120b (12), y NVIDIA reporta 51.56 en SWE-bench Verified. Su argumento es el throughput: Artificial Analysis midió casi 670 tokens/s con los pesos NVFP4 en el lanzamiento. Sus versiones de 4 bits ocupan 21-25.5GB en disco. Para un pipeline de mucho volumen (refactorizaciones por lotes, generación de tests, triaje de logs) ese compromiso puede compensar; para cualquier cosa que tenga que pensar, no.
11. Mistral Medium 3.5 y Devstral Small 2 (Mistral AI)
Captura: huggingface.co/mistralai/Mistral-Medium-3.5-128B, octubre de 2026.
La línea de programación de Mistral se ha concentrado. Mistral Medium 3.5 (abril de 2026) es un modelo denso de 128B con una licencia MIT modificada, un contexto de 256K y un 77.6% en SWE-bench Verified, y su ficha dice que reemplaza a Devstral y sustituye a Devstral 2 en Vibe CLI, el agente de programación de terminal open source de Mistral. Necesita unos 80GB en 4 bits, pero solo saca 14 en el índice actual.
El hermano pequeño es la razón por la que Mistral sigue en esta lista. Devstral Small 2 (24B, Apache 2.0, diciembre de 2025) saca un 68.0% en SWE-bench Verified, acepta imágenes, tiene un contexto de 256K y funciona en una sola RTX 4090 o en un Mac de 32GB. Qwen3.8-27B lo supera con un tamaño parecido, pero Devstral Small 2 con Vibe CLI es un flujo de trabajo ya montado.
Menciones de honor
StarCoder 2 de BigCode viene en tamaños de 3B, 7B y 15B con un contexto de 16K. El de 15B se entrenó con más de 600 lenguages de The Stack v2, y cada archivo de código fuente de su conjunto de entrenamiento lleva un identificador de Software Heritage, lo que lo convierte en el modelo de programación más auditable que existe. Elígelo cuando lo que te frena sea el cumplimiento en propiedad intelectual y no la capacidad.
Kimi K2.7-Code (12 de junio) es la línea de programación de Moonshot: un MoE de 1T con 32B activos y un contexto de 262K que gasta alrededor de un 30% menos de tokens de razonamiento que K2.6. Una variante HighSpeed sirve a unos 180 tokens/s. Mantiene la licencia MIT modificada que K3 abandonó, con cerca de un tercio del tamaño de K3.
Captura: huggingface.co/ibm-granite/granite-4.2-30b, octubre de 2026.
IBM Granite 4.2 (25 de agosto) viene en modelos densos de 3B, 8B y 30B bajo Apache 2.0, con un contexto de 128K ampliable a 512K y un modo de razonamiento. El de 30B saca 57.0 en SWE-bench Verified y 33.29 en SWE-Bench Pro. En capacidad no compite, pero es la opción empresarial con la licencia más limpia, igual que la línea Granite Code, más antigua, de IBM (de 3B a 34B, entrenada con 116 lenguajes).
Yi-Coder de 01.AI viene en tamaños de 1.5B y 9B con un contexto de 128K bajo Apache 2.0, y Yi-Coder-9B-Chat saca un 85.4% en HumanEval. Es lo bastante pequeño para autocompletar código en hardware modesto.
A seguir de cerca: Reflection AI anunció Beam el 5 de octubre, un MoE de 501B con 23B activos que reporta 65.5 en SWE-Bench Pro y 80.1 en Terminal-Bench 2.1. Los pesos con Apache 2.0 están prometidos para más adelante en octubre, pero todavía no están en Hugging Face.
Cómo usar estos modelos con un agente de programación
La configuración local más rápida es OpenCode, un agente de programación de terminal open source, con Ollama sirviendo el modelo. Ollama puede lanzar OpenCode directamente, así que son unos pocos comandos.
Paso 1: Instala Ollama
curl -fsSL https://ollama.com/install.sh | sh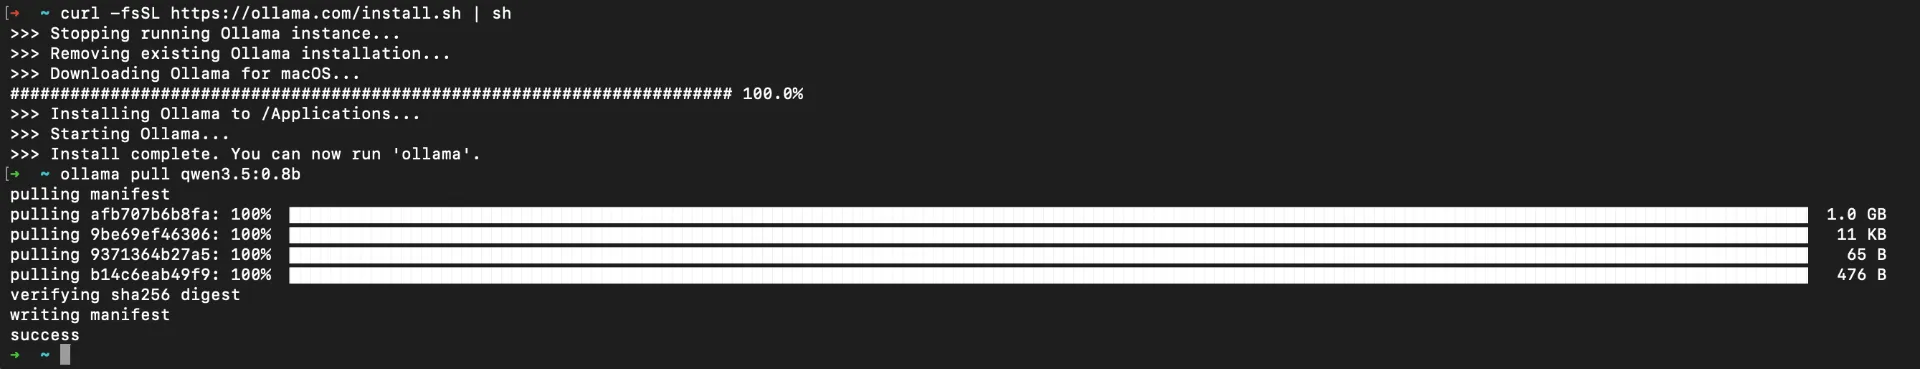
Paso 2: Instala OpenCode
curl -fsSL https://opencode.ai/install | bash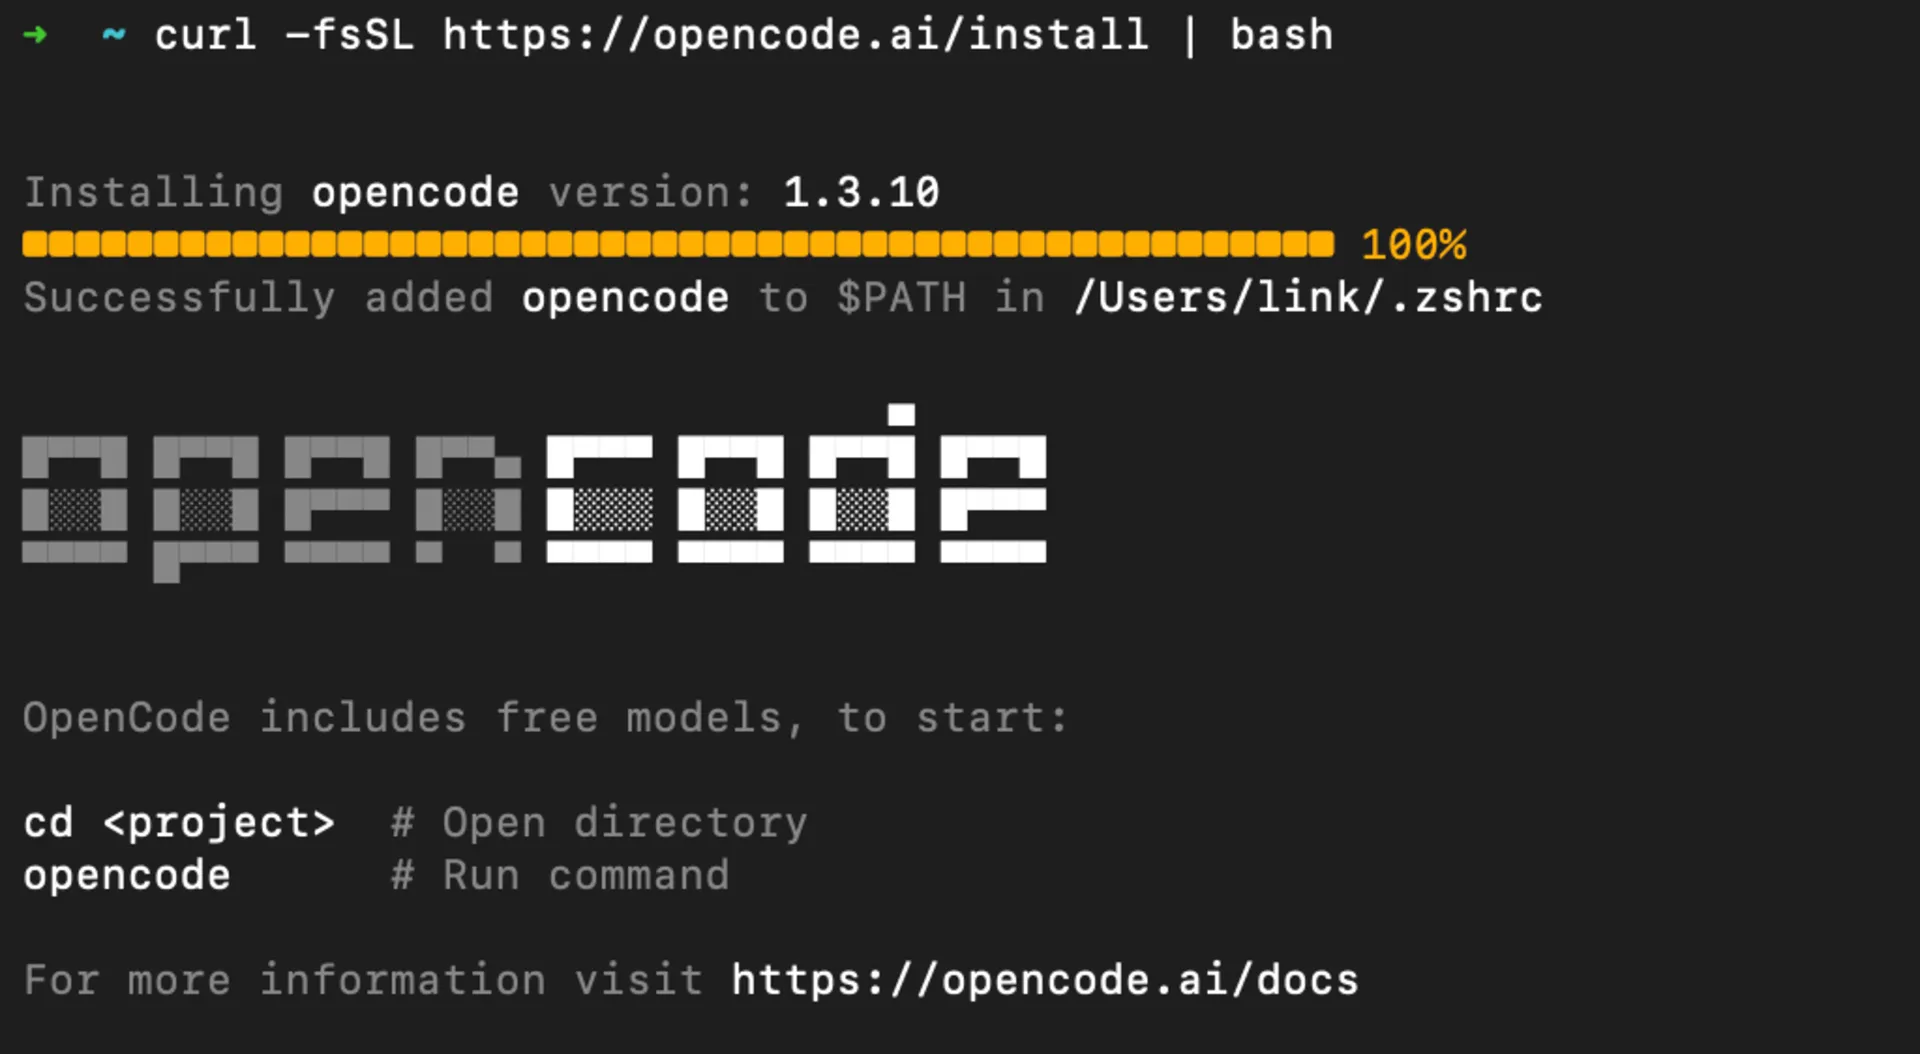
Paso 3: Dale al modelo contexto suficiente
OpenCode necesita al menos 64K tokens de contexto, y el valor por defecto de Ollama es menor en la mayoría de GPUs de consumo: 4K por debajo de 24GiB de VRAM y 32K hasta 48GiB. Arranca el servidor con una ventana más grande (en macOS, cierra antes la app de Ollama para que el puerto quede libre):
OLLAMA_CONTEXT_LENGTH=64000 ollama servePaso 4: Lanza OpenCode a través de Ollama
En una segunda terminal:
ollama launch opencode --model qwen3.8:27b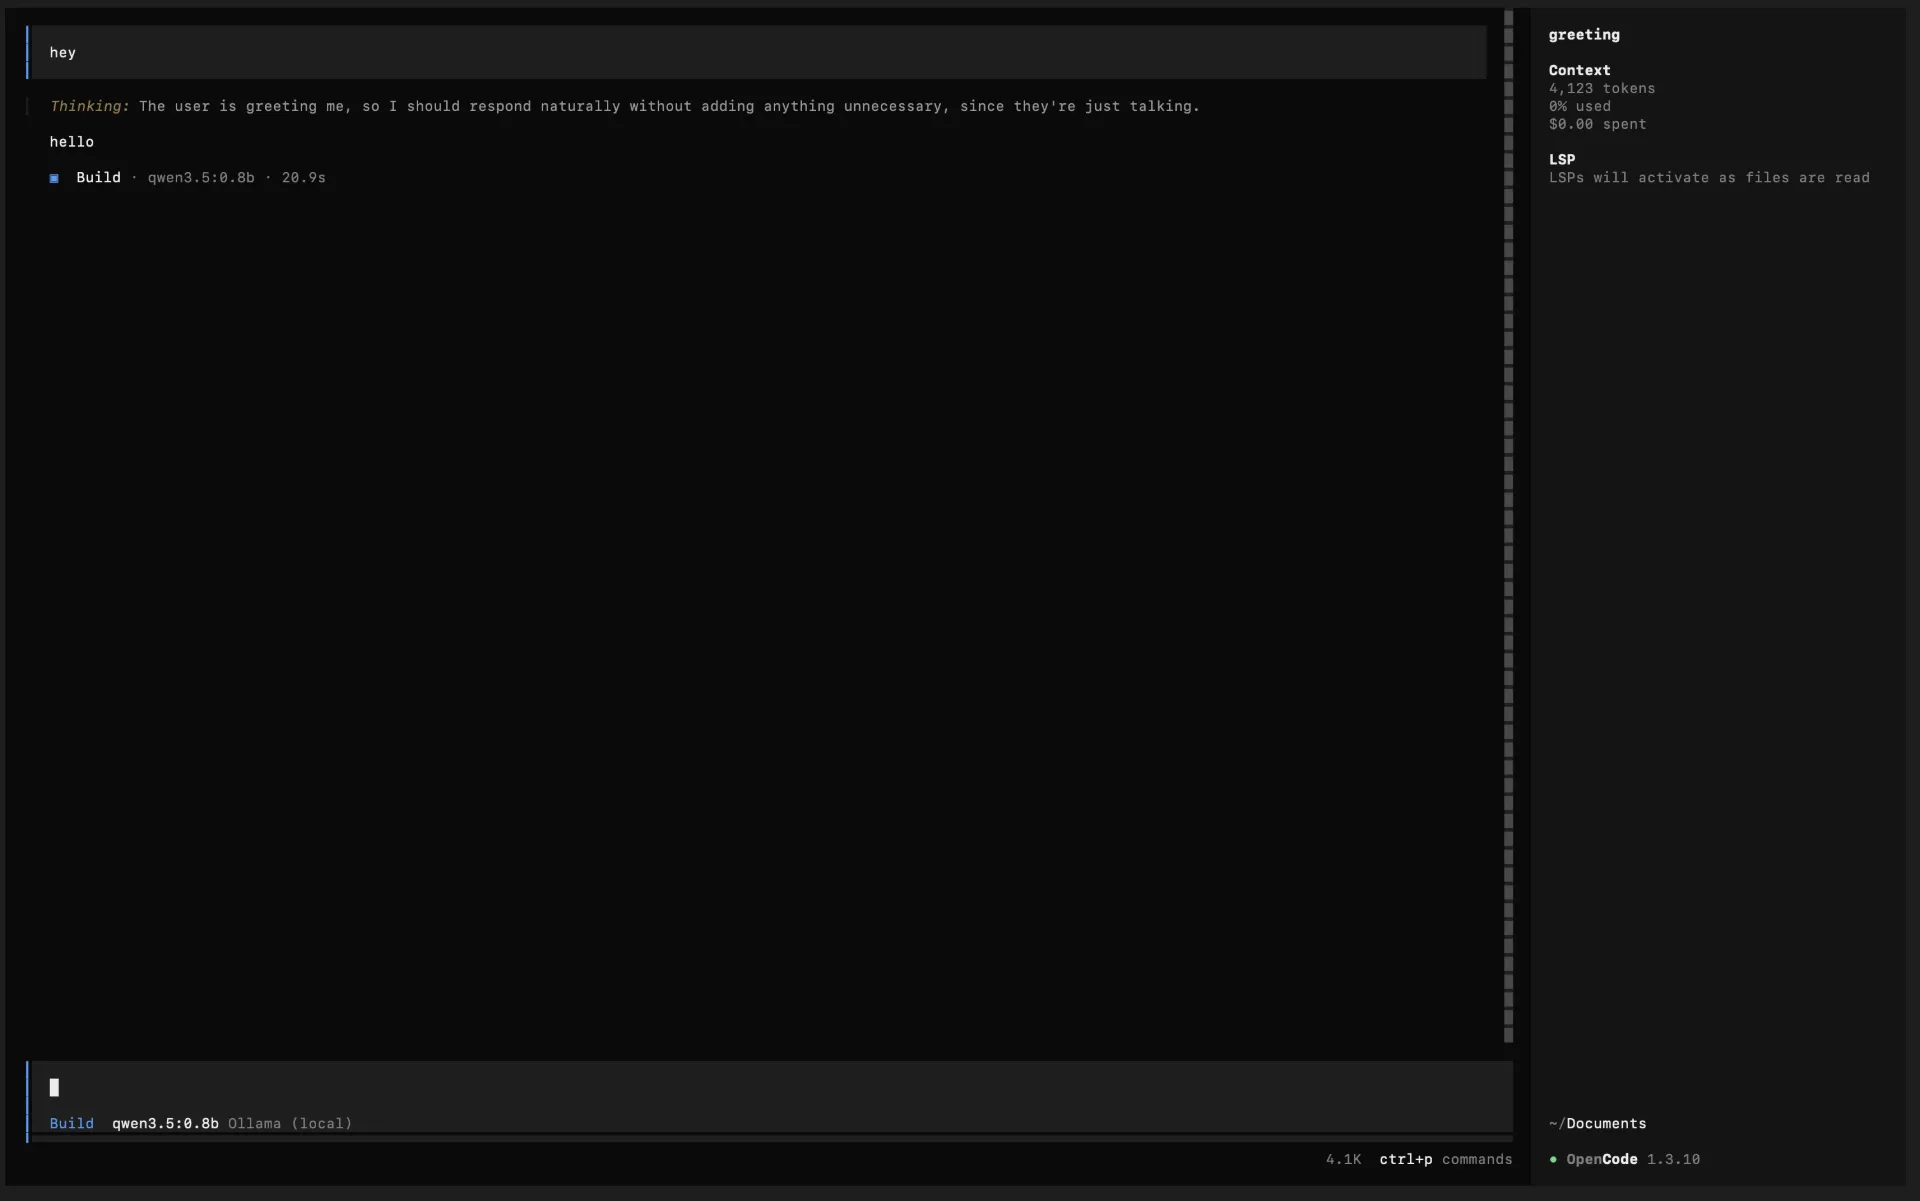
En un Mac con Apple Silicon, usa el tag qwen3.8:27b-mlx (también de 18GB), que funciona sobre el backend MLX de Apple. Después abre tu repositorio y úsalo como cualquier otro agente de programación de terminal. Qwen3.8-27B piensa mucho por defecto, así que si las ediciones interactivas se te hacen lentas, baja el esfuerzo de razonamiento para el chat y mantenlo alto para las ejecuciones largas del agente.
Cómo ejecutar Qwen3.8-Flash-Next en un Mac de 128GB
Ollama es el camino fácil para Qwen3.8-27B. Flash-Next en un Mac requiere más cuidado, por un límite que la ficha técnica de Apple no menciona: macOS no le da a la GPU toda la memoria unificada. Por defecto puede fijar (wire) alrededor del 75%, unos 96GB en una máquina de 128GB. Comprueba el tuyo (0 significa que rige el valor por defecto):
sysctl iogpu.wired_limit_mbUn GGUF estándar de Flash-Next en 4 bits necesita 96-114GB, así que queda en el límite o por encima antes de añadir nada de caché KV. Puedes subir el límite con sudo sysctl iogpu.wired_limit_mb=<MB>, que dura hasta el siguiente reinicio (nuestro artículo sobre el Mac Studio de 512GB explica cuánto hay que dejarle a macOS), pero en una máquina de 128GB eso deja muy poco para el contexto. Hay una opción mejor.
Deja la tabla de n-gramas en el SSD
La tabla de n-gramas de 51B es una búsqueda, no una multiplicación de matrices. Cada token hashea sus tres últimos tokens y lee 16 filas, unos 2.7KB, así que la tabla puede quedarse en disco y cargarse bajo demanda. A 36 tokens/s eso son unos 3MB/s de lecturas, y los n-gramas comunes se quedan en la caché de páginas. llama.cpp mapea en memoria los archivos GGUF por defecto, así que en principio ya funciona así. El problema, según la ficha del modelo de Atomic Chat, es que Metal fija toda la región mapeada de cualquier shard que contenga un tensor de GPU, así que una tabla que comparte shard con otros pesos acaba fijada en la memoria de GPU junto con ellos. Las versiones “AD” de Atomic Chat ponen la tabla sola en su propio shard, y así queda fuera:
| Versión | Memoria de GPU | En el SSD | KLD medio | Mismo token top-1 |
|---|---|---|---|---|
AD-3.84bpw-IQ4_XS-M64 | 45.8GB | 39.1GB | 0.2277 | 82.68% |
AD-4.27bpw-Q4_K_M-M64 | 56.1GB | 38.4GB | 0.0842 | 89.49% |
AD-5.00bpw-Q5_K_M-M64 | 56.1GB | 54.4GB | 0.0837 | 89.55% |
Descarga la versión de 4.27bpw. Iguala a la de 5.00bpw dentro del margen de error de medida, y con 56GB deja unos 40GB libres bajo el límite por defecto, así que no tienes que tocar el sysctl para nada. Dos advertencias sobre los nombres. La cifra de bpw es la media de todo el archivo, y la tabla de n-gramas en Q5_1 es el 41% de él, así que los pesos de los expertos que van en la memoria de GPU están entre 2.5 y 4.5 bits; la columna KLD es el dato de calidad en el que fiarse. Y la versión de 3.84bpw es la que permite meter Flash-Next en un Mac de 64GB (Atomic Chat midió 36 tokens/s en un M5 Max de 64GB, y una prueba independiente obtuvo 17.6 tokens/s en un M1 Max de 64GB), pero la mayoría de sus pesos de expertos están a 1.75 bits y su KLD es 2.7 veces mayor. La rama principal de llama.cpp soporta la arquitectura desde el 27 de agosto (PR #27742). Deja mmap activado, que es lo predeterminado, ya que es justo lo que permite paginar la tabla.
Añade un modelo pequeño al lado
Ese margen da para un segundo modelo, y una buena forma de aprovecharlo es combinar Flash-Next como caballo de batalla con Gemma 4 26B-A4B para tareas rápidas e imágenes. Gemma es un modelo de mezcla de expertos con unos 4B de parámetros activos, Artificial Analysis lo estima en 17 en el mismo índice, y la versión QAT de Unsloth ocupa 14.2GB.
| Modelo | Versión | Memoria de GPU |
|---|---|---|
| Qwen3.8-Flash-Next | Atomic Chat AD-4.27bpw-Q4_K_M-M64, tabla en el SSD | 56.1GB |
| Gemma 4 26B-A4B | Unsloth QAT UD-Q4_K_XL | 14.2GB |
| Total de pesos | ~70GB de los ~96GB por defecto |
OpenCode ya reparte el trabajo así. Su opción small_model se encarga de llamadas ligeras como los títulos de sesión, y sin ella esas llamadas van a tu modelo principal, donde compiten con el turno del agente que estás esperando. Ejecuta cada modelo en su propio llama-server:
# Workhorse on port 8080 (Q4_K_M picks the 4.27bpw build)
llama-server -hf AtomicChat/Qwen3.8-Flash-Next-GGUF:Q4_K_M \
  --jinja -ngl 99 -c 65536 -fa on -fit off --port 8080

# Small model on port 8081
llama-server -hf unsloth/gemma-4-26B-A4B-it-qat-GGUF:UD-Q4_K_XL \
  --jinja -ngl 99 -c 32768 --port 8081
Flash-Next necesita --jinja (sin él, los turnos pueden salir mal formados) y -fit off, porque el ajuste automático de memoria de llama.cpp falla con esta arquitectura. La ficha no publica tamaños de caché KV y sus propios ejemplos se quedan en 32K, así que vigila la presión de memoria en el Monitor de Actividad la primera vez que lleves una sesión hacia los 64K que necesita OpenCode. Después apunta OpenCode a los dos servidores en opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "mac": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Flash-Next on this Mac",
      "options": { "baseURL": "http://localhost:8080/v1" },
      "models": { "flash-next": { "name": "Qwen3.8-Flash-Next" } }
    },
    "mac-small": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Gemma on this Mac",
      "options": { "baseURL": "http://localhost:8081/v1" },
      "models": { "gemma-4-26b": { "name": "Gemma 4 26B-A4B" } }
    }
  },
  "model": "mac/flash-next",
  "small_model": "mac-small/gemma-4-26b"
}
El precio son 14GB que Flash-Next podría dedicar al contexto, así que si las sesiones largas empiezan a ir justas, quita Gemma primero. Tampoco lo necesitas para las imágenes: Flash-Next las lee él mismo con el proyector mmproj-Qwen3.8-Flash-Next-F16.gguf de 0.9GB que hay en el mismo repo. Y si prefieres no usar la terminal, la app de escritorio Atomic Chat ejecuta las mismas versiones.
Ejecutar el modelo en una máquina con GPU y programar desde el portátil
Una configuración habitual es una estación de trabajo con la GPU en casa o en la oficina y un portátil para todo lo demás. Ollama solo escucha en localhost, y rechaza las peticiones cuya cabecera Host no sea un nombre local, así que un túnel normal recibe un 403 Forbidden. Un túnel de Pinggy puede reescribir la cabecera y exigir una clave. En la máquina con GPU, ejecuta:
ssh -p 443 -R0:localhost:11434 free.pinggy.io "u:Host:localhost:11434" "k:change-me"Imprime URLs HTTPS públicas como https://<random>.run.pinggy-free.link, y las peticiones sin Authorization: Bearer change-me reciben un 401. Los clientes compatibles con OpenAI envían justo esa cabecera con su API key, así que en el portátil apuntas el opencode.json de OpenCode al túnel y pones la clave:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "gpubox": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama on my GPU box",
      "options": {
        "baseURL": "https://<random>.run.pinggy-free.link/v1",
        "apiKey": "change-me"
      },
      "models": {
        "qwen3.8:27b": { "name": "Qwen3.8-27B" }
      }
    }
  }
}
Los túneles gratuitos duran 60 minutos y cambian de URL cada vez, lo cual vale para una sesión rápida. Para una máquina contra la que programas a diario, un token de Pinggy Pro quita el límite de tiempo y mantiene la URL estable.
Cómo autoalojar estos modelos
Una vez elegido el modelo, estas guías cubren el resto:
- Cómo autoalojar cualquier LLM explica cómo ejecutar Ollama y Open WebUI en Docker, descargar un modelo y compartir la instalación fuera de tu red.
- Las mejores herramientas y modelos LLM locales compara LM Studio, Unsloth, Ollama y otras, y enumera qué modelos caben en 128GB.
- El mejor hardware para agentes de programación autoalojados trata las GPUs y las máquinas con memoria unificada.
Conclusión
Es tu hardware el que elige el modelo, no el leaderboard. Con una GPU, ejecuta Qwen3.8-27B: Apache 2.0, 16-19GB en 4 bits, y saca 34 en el índice frente a los 25 del siguiente mejor modelo pequeño. Con un Mac de 128GB, ejecuta Qwen3.8-Flash-Next si su licencia te encaja, en la versión de Atomic Chat que deja la tabla de n-gramas en el SSD; con 56GB aún te queda sitio para un segundo modelo pequeño. Con tres o cuatro GPUs de 80GB, ejecuta GLM-5.3-Flash bajo MIT. Con ocho H200, MiMo-V2.6-Pro es el mejor modelo de pesos abiertos y además trae la licencia más sencilla de los líderes. Kimi K3 necesita al menos ocho GPUs de la clase GB300.
En la escala actual de Artificial Analysis, el mejor modelo de pesos abiertos saca 46 frente a los 58 de Claude Opus 5.5. En el Terminal-Bench 2.1 que publican los fabricantes, los pesos abiertos ya se han puesto al día. Vuelve a mirar las dos cosas dentro de un mes; este campo se mueve así de rápido.