En este artículo
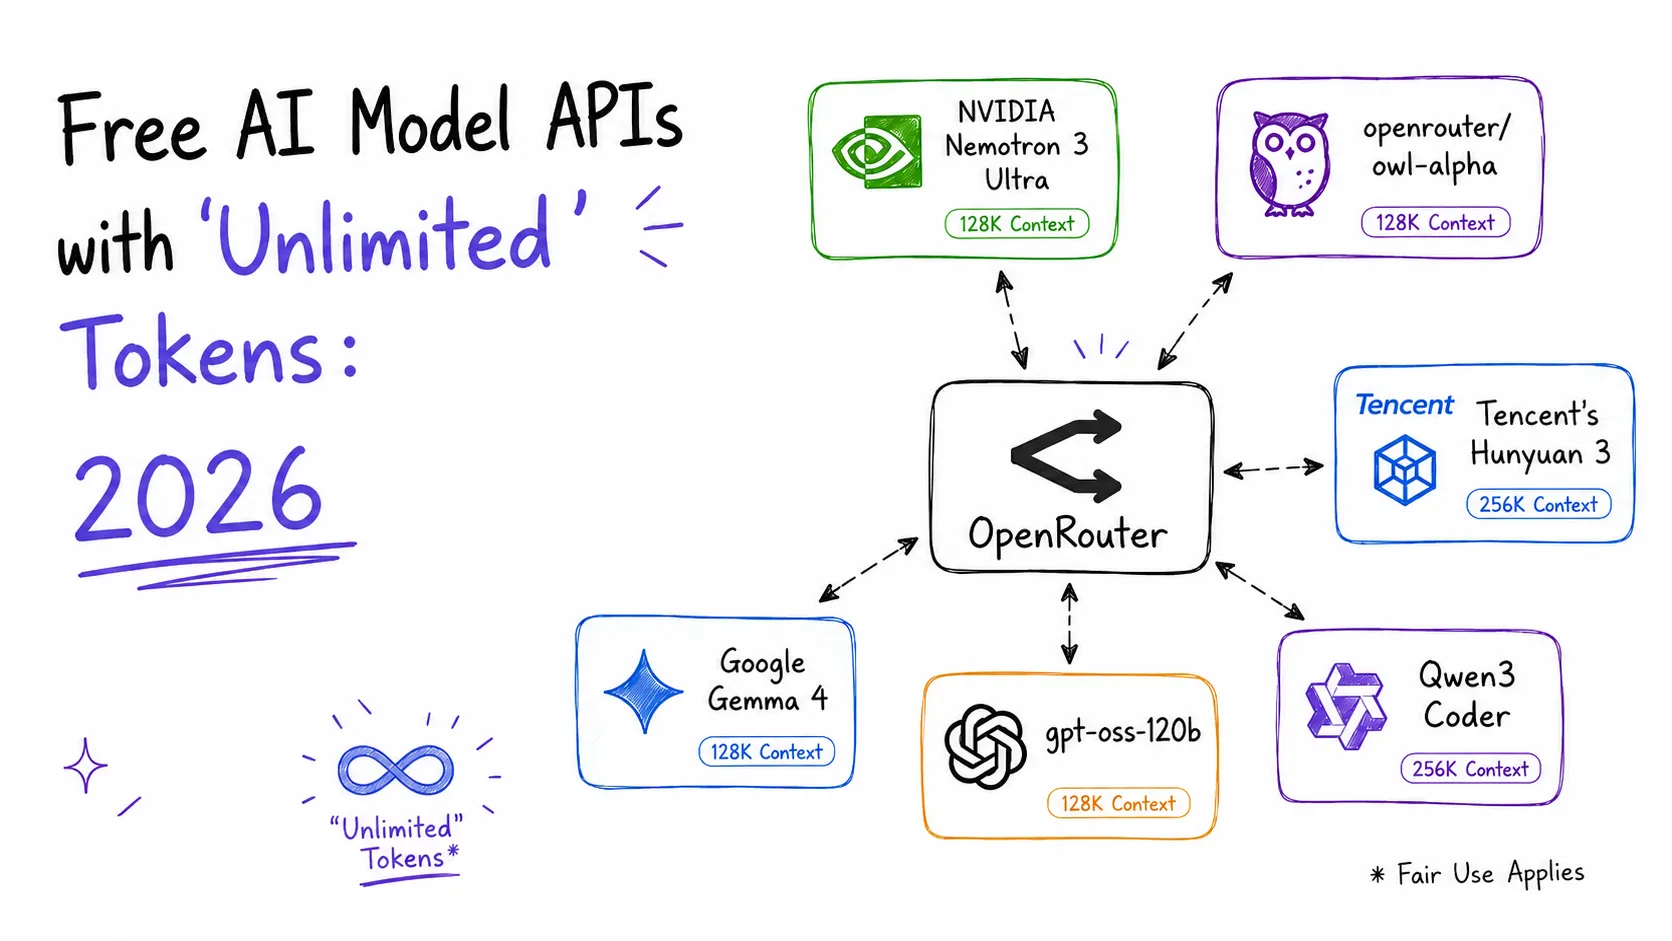
La mayoría de los desarrolladores se topan con el mismo muro en cuanto empiezan a construir con modelos de lenguaje grandes: el prototipo funciona y, a partir de ahí, la factura de la API empieza a apuntar cada experimento. Los modelos de frontera siguen cobrando por token. Claude Opus 5.5 tiene un precio de lista de $4 por millón de tokens de entrada y $20 por millón de tokens de salida, y eso sube rápido en cuanto lo llamas dentro de un bucle.
Busca “API de IA gratis con tokens ilimitados” y encontrarás un montón de artículos que prometen una forma de esquivarlo. La versión honesta es menos emocionante pero más útil: OpenRouter te da acceso sin tarjeta de crédito a un conjunto rotativo de modelos a $0 por token, pero “ilimitado” no es la palabra correcta. Tienes 20 peticiones por minuto y 50 o 1,000 peticiones al día, según hayas comprado o no $10 en créditos. No hay tope de tokens, pero sí un tope de peticiones muy real.
La lista gratuita además cambia rápido. En julio de 2026, Owl Alpha, Tencent Hy3, Qwen3 Coder y gpt-oss-120b eran gratis en OpenRouter; hoy no lo es ninguno, y encabezan la lista Inkling, el modelo de 975 mil millones de parámetros de Thinking Machines, y la familia Nemotron de NVIDIA. Todos los límites, precios e IDs de modelo de este artículo se comprobaron contra la API en vivo y las páginas de modelos de OpenRouter el 27 de octubre de 2026.
Este es el catálogo gratuito actual de un vistazo, antes de entrar en cómo funciona:
| Modelo | Tamaño | Contexto (gratis) | Ideal para |
|---|---|---|---|
| Thinking Machines Inkling | MoE de 975B / 41B activos | 1M tokens | Programación y entornos agénticos, entrada de texto, imagen y audio |
| NVIDIA Nemotron 3 Ultra | MoE de 550B / 55B activos | 1M tokens | Razonamiento general, orquestación de agentes |
| NVIDIA Nemotron 3.5 Super VL | MoE de 120B / 12B activos | 1M tokens | Entrada de documentos, capturas de pantalla y vídeo |
| Google Gemma 4 | 31B denso / 26B-A4B MoE | 262K tokens | Entrada multimodal, function calling, más de 140 idiomas |
| Poolside Laguna S 2.1 | MoE de 118B / 8B activos | 262K tokens | Agentes de programación, se retira el 31 de octubre de 2026 |
| openrouter/free | Router sobre los modelos gratuitos | 200K tokens | Código que tiene que seguir funcionando aunque roten los modelos |
Esa tabla recoge los seis que merece la pena conocer uno por uno. Si cuentas los modelos de embeddings, reranking, voz y de “decisión”, OpenRouter lista ahora mismo 28 IDs de modelo que terminan en :free, 16 de ellos modelos de chat, y del resto hablamos más abajo.
Resumen
Qué significa “gratis” en OpenRouter: los modelos cuyo ID termina en :free cuestan $0 por token de entrada y de salida. El límite está en las peticiones, no en los tokens: 20 peticiones/minuto siempre, más 50 peticiones/día hasta que hayas comprado $10 en créditos en total, y 1,000 peticiones/día a partir de ahí. El nivel depende de lo que has comprado en toda la vida de la cuenta, así que gastar el saldo no te devuelve a 50.
Primeros pasos: crea una cuenta en openrouter.ai/keys (email o GitHub, sin tarjeta), genera una API key y llama al endpoint compatible con OpenAI en https://openrouter.ai/api/v1/chat/completions con cualquier ID de modelo que termine en :free. Un GET a https://openrouter.ai/api/v1/key te dice cuántas peticiones gratuitas te quedan hoy.
Modelos gratuitos que conviene conocer ahora mismo (octubre de 2026, compruébalo antes de depender de uno): Inkling, Nemotron 3 Ultra, Nemotron 3.5 Super VL, Gemma 4 y Laguna S 2.1 (hasta el 31 de octubre), además del router openrouter/free. Owl Alpha, Tencent Hy3, Qwen3 Coder y gpt-oss eran gratis en julio y ya no lo son.
La trampa más allá de los límites: los endpoints gratuitos suelen registrar lo que envías. NVIDIA, Thinking Machines y Poolside indican en sus páginas de modelo en OpenRouter que el tráfico del nivel gratuito se registra o puede usarse para mejorar sus modelos, así que no les mandes datos confidenciales.
El consejo de fiabilidad: los modelos gratuitos salen de la lista con poco aviso. Pon 2-3 modelos gratuitos de respaldo en el array models de OpenRouter en lugar de dejar fijo en el código un único ID de modelo.
Estos modelos gratuitos sirven para algo más que llamadas directas a la API. Agentes de programación como OpenCode traen OpenRouter como proveedor integrado, y ya explicamos de principio a fin cómo ejecutar Hermes Agent con los modelos gratuitos de OpenRouter. Esta guía se centra en el nivel gratuito en sí: cuánto cuesta, qué limita y qué modelos incluye ahora mismo.
El nivel gratuito: límites de peticiones, no de tokens
Esta es la parte que la mayoría de artículos sobre “tokens ilimitados” cuentan mal. Los modelos gratuitos de OpenRouter cobran $0.00 por token de entrada y $0.00 por token de salida, así que de verdad no hay facturación por tokens. Lo que sí tiene toda cuenta es un tope de peticiones, documentado en la página de límites de OpenRouter:
- 20 peticiones por minuto, siempre, sea cual sea el estado de la cuenta
- 50 peticiones al día si has comprado menos de $10 en créditos en total
- 1,000 peticiones al día en cuanto tus compras de créditos llegan a $10
La documentación dice que el nivel diario “se elige según el total de créditos comprados”, así que cuenta lo que has comprado durante toda la vida de la cuenta, no tu saldo actual. Una vez que pasas de $10, el techo más alto se mantiene aunque después tu saldo baje a cero. En la práctica, el nivel de 1,000 empieza a partir de 9 créditos, uno por debajo del umbral, algo que según OpenRouter sirve para absorber redondeos y comisiones de recarga.
Así que una conversación de 100,000 tokens te cuesta una petición, lo mismo que un prompt de dos palabras, y un bucle de agente que llama al modelo docenas de veces por tarea choca con el techo diario mucho antes de que importe ningún recuento de tokens. Hay dos cosas más que pueden frenarte: la protección DDoS de Cloudflare bloquea las peticiones que “superan drásticamente un uso razonable”, y un saldo de créditos negativo también puede bloquear los modelos gratuitos, con errores 402. Eso pasa sobre todo si usas modelos de pago junto a los gratuitos y dejas que el saldo se agote.
Cómo comprobar cuántas peticiones gratuitas te quedan
OpenRouter muestra el contador diario en su endpoint de la key:
curl https://openrouter.ai/api/v1/key \
  -H "Authorization: Bearer $OPENROUTER_API_KEY"
La respuesta incluye un objeto free_model_daily_requests con los contadores used, limit y remaining del día UTC en curso. Un agente puede consultarlo antes de una ejecución larga en lugar de descubrir el techo a base de errores 429 “Rate limit exceeded” a mitad de camino. Eso sí, no informa del límite por minuto. Cuando llegas a un límite, la respuesta 429 trae cabeceras X-RateLimit-* que describen cuál has alcanzado.
Configuración inicial
- Ve a openrouter.ai/keys y regístrate con email o GitHub. No necesitas tarjeta de crédito para los modelos gratuitos.
- Genera una API key en esa página. Si quieres, puedes ponerle a cada key un límite de créditos.
- (Opcional, recomendado) Compra créditos. El pago por uso tiene una comisión de plataforma del 5.5% sobre las compras de créditos (8% en el plan Business), y $10 en compras en total es lo que sube tu techo de modelos gratuitos a 1,000 peticiones al día. Es un umbral que se cruza una vez, no una suscripción.
- Llama a la API. Los modelos gratuitos llevan el sufijo
:freeen su ID, y la colección Free Models de OpenRouter es la forma más rápida de ver qué hay disponible hoy.
Si solo piensas usar modelos gratuitos, puedes quedarte en el paso 2 y gastar $0. Los $10 sirven unicamente para subir el techo diario, y vale la pena pagarlos en cuanto un proyecto se convierte en algo que usas todos los días, porque 50 peticiones se van volando cuando estás iterando sobre prompts. Antes de comprar, ten en cuenta que el FAQ de OpenRouter dice que se reserva el derecho a hacer caducar los créditos sin usar un año después de la compra.
Cómo llamar a un modelo gratuito
Como OpenRouter replica la forma de la API de OpenAI, puedes usar curl directamente o el SDK estándar openai de Python/JS apuntando a otra URL base. Esta es la versión con HTTP a secas:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {"role": "user", "content": "Explain the difference between MoE and dense transformer architectures in two sentences."}
    ]
  }'
Y la misma llamada con el SDK oficial de OpenAI para Python, simplemente apuntado a OpenRouter:
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="sk-or-v1-your-key-here",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {"role": "user", "content": "Explain the difference between MoE and dense transformer architectures in two sentences."}
    ],
)

print(response.choices[0].message.content)
Ni SDK específico de OpenRouter ni librería cliente propia. Si tu código ya habla con la API de OpenAI, cambiar base_url y la cadena model es toda la migración.
Cómo gestionar la rotación y los límites con modelos de respaldo
El consejo más importante para usar el nivel gratuito en producción: no fijes un único modelo gratuito en el código. Las variantes gratuitas se retiran o cambian de precio sin mucho aviso. Entre julio y finales de octubre de 2026 han desaparecido qwen/qwen3-coder:free, openai/gpt-oss-120b:free, tencent/hy3:free y nvidia/nemotron-3-super-120b-a12b:free, y cualquier código atado a ellos ahora falla. El array models de OpenRouter te deja listar varios candidatos por orden de prioridad en una sola petición:
{
  "models": [
    "nvidia/nemotron-3-ultra-550b-a55b:free",
    "google/gemma-4-31b-it:free",
    "nvidia/nemotron-3.5-lightning:free"
  ],
  "messages": [
    {"role": "user", "content": "Summarize this changelog in three bullet points."}
  ]
}
Por defecto, cualquier error puede mandar la petición al siguiente modelo, incluidos errores de longitud de contexto, avisos de moderación, límites de peticiones y caídas del proveedor. Se te cobra el modelo que respondió, y su ID vuelve en el campo model de la respuesta, así que puedes registrar qué respaldo entró en juego. Que todas las entradas sean modelos :free: si la lista acaba cayendo en uno de pago, pagas la tarifa de ese modelo.
Si prefieres no gestionar ninguna lista, openrouter/free es un router que elige al azar un modelo gratuito entre los que soportan lo que necesita tu petición, como llamada a herramientas, salidas estructuradas o entrada de imágenes. Cambia previsibilidad por comodidad: no controlas qué modelo responde, pero tu código sigue funcionando aunque cambie el catálogo gratuito.
Cómo salen los modelos gratuitos de OpenRouter
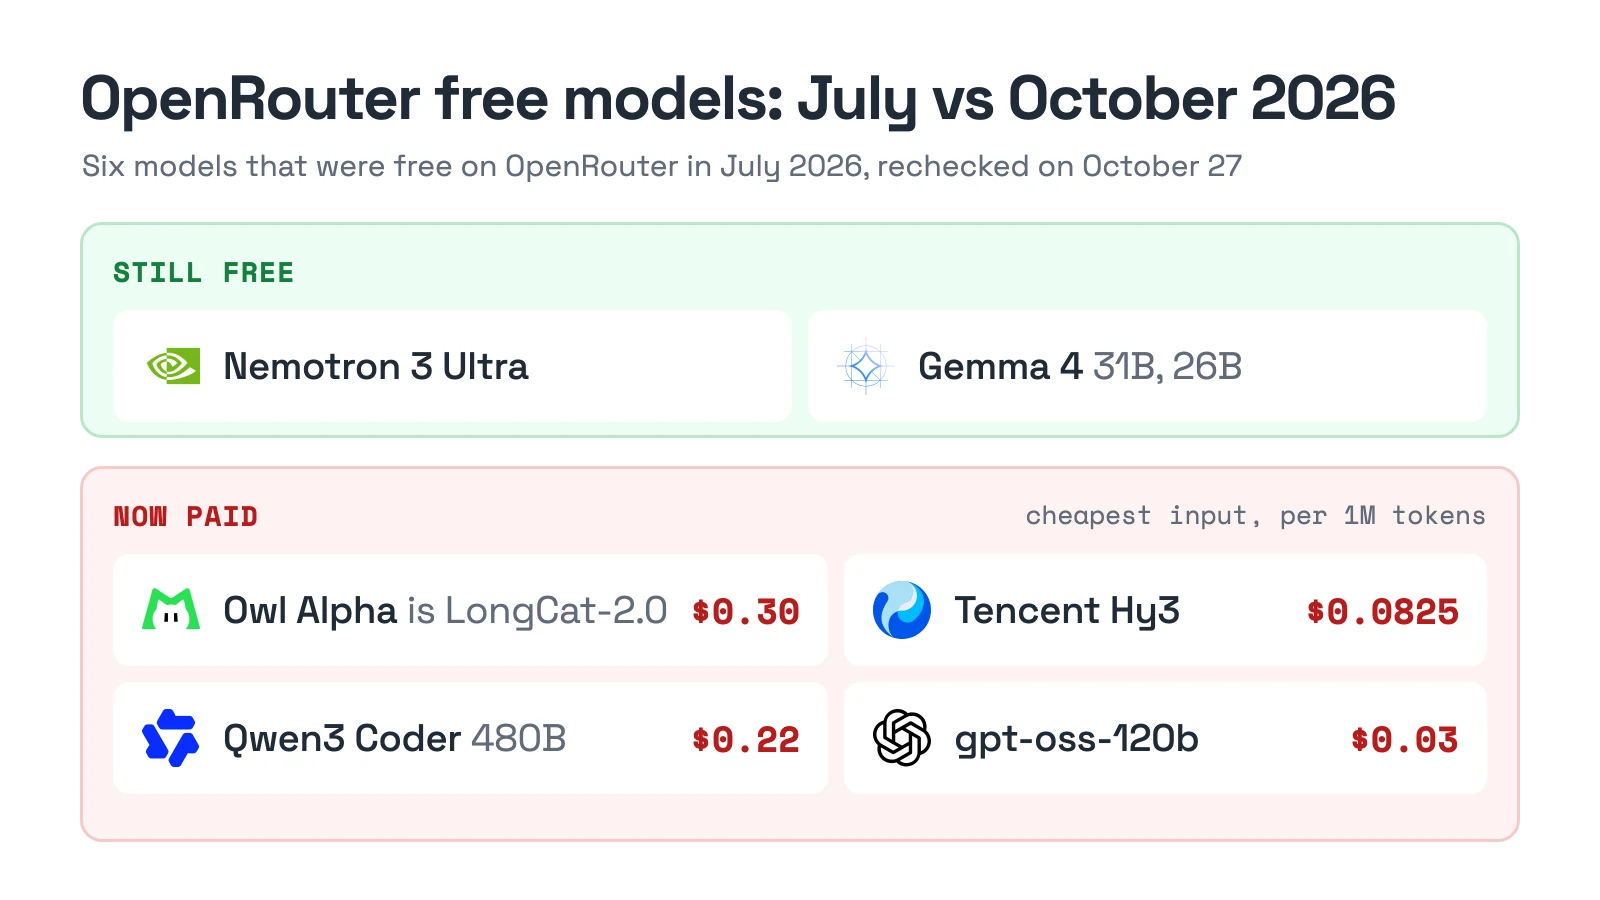
Precios: el proveedor más barato de OpenRouter por millón de tokens de entrada, 27 de octubre de 2026.
Hace tres meses la lista gratuita era otra. En julio, Nemotron 3 Ultra, Gemma 4, Owl Alpha, Tencent Hy3, Qwen3 Coder y gpt-oss-120b eran todos gratis. Solo los dos primeros lo siguen siendo, y los otros cuatro muestran las distintas maneras en que se acaba un modelo gratuito.
Owl Alpha resultó ser LongCat-2.0 de Meituan. Era un modelo stealth, un checkpoint previo al lanzamiento que OpenRouter sirve gratis bajo un nombre en clave mientras el laboratorio recoge uso real. A finales de junio, el equipo LongCat de Meituan presentó LongCat-2.0 como “el modelo completo detrás de Owl Alpha”: 1.6 billones de parámetros, unos 48B activos por token y un contexto de 1M tokens. Los pesos están en Hugging Face con licencia MIT, y en OpenRouter meituan/longcat-2.0 cuesta $0.30/M de entrada y $1.20/M de salida, que ahora aparece como precio con descuento.
Lo mismo volvió a pasar este otoño. Un modelo stealth llamado Space Bunny salió de OpenRouter el 5 de octubre y volvió el 19 de octubre como MiniMax M3.1 Flash, gratis durante 72 horas y ahora de pago, desde $0.143/M de entrada. A 27 de octubre no hay ningún modelo stealth en la lista, así que no hagas planes contando con uno.
La ventana gratuita de Tencent Hy3 se cerró. Tencent había fijado el 21 de julio como fecha de fin de la oferta gratuita, y Hy3 ahora es solo de pago, desde $0.0825/M de entrada y $0.33/M de salida a través del endpoint propio de Tencent.
Qwen3 Coder y gpt-oss-120b perdieron sus variantes :free. Los dos siguen en OpenRouter como modelos de pago: Qwen3 Coder desde $0.22/M de entrada, y gpt-oss-120b desde $0.03/M de entrada y $0.15/M de salida entre unas dos docenas de proveedores. A ese precio, gpt-oss está cerca de ser gratis de todos modos. Los modelos gratuitos más pequeños de julio siguieron el mismo camino: las variantes gratuitas de Llama 3.3 70B, Llama 3.2 3B y Hermes 3 405B ya no están, y Nemotron 3 Super de NVIDIA perdió su endpoint gratuito a finales de octubre (de pago desde $0.08/M de entrada). DeepSeek sigue sin modelo gratuito, aunque V4.1 Flash aparece a $0.14/M de entrada y $0.42/M de salida.
El catálogo de modelos gratuitos ahora mismo
El catálogo gratuito de OpenRouter es un blanco móvil: se añaden modelos cuando los laboratorios promocionan un lanzamiento y se retiran cuando termina la promoción. El 27 de octubre de 2026, la API lista 28 IDs de modelo que terminan en :free: 16 modelos de chat, siete de embeddings y reranking, dos de texto a voz y tres modelos de “decisión” que devuelven respuestas puntuadas en lugar de texto libre. Según el uso de la semana pasada, la página Free Models de OpenRouter sitúa a Nemotron 3 Ultra, Nemotron 3.5 Super VL y Nemotron 3.5 Lightning como los más usados. Cinco de los modelos de chat merecen un apartado propio.
Thinking Machines Inkling (975B-A41B)
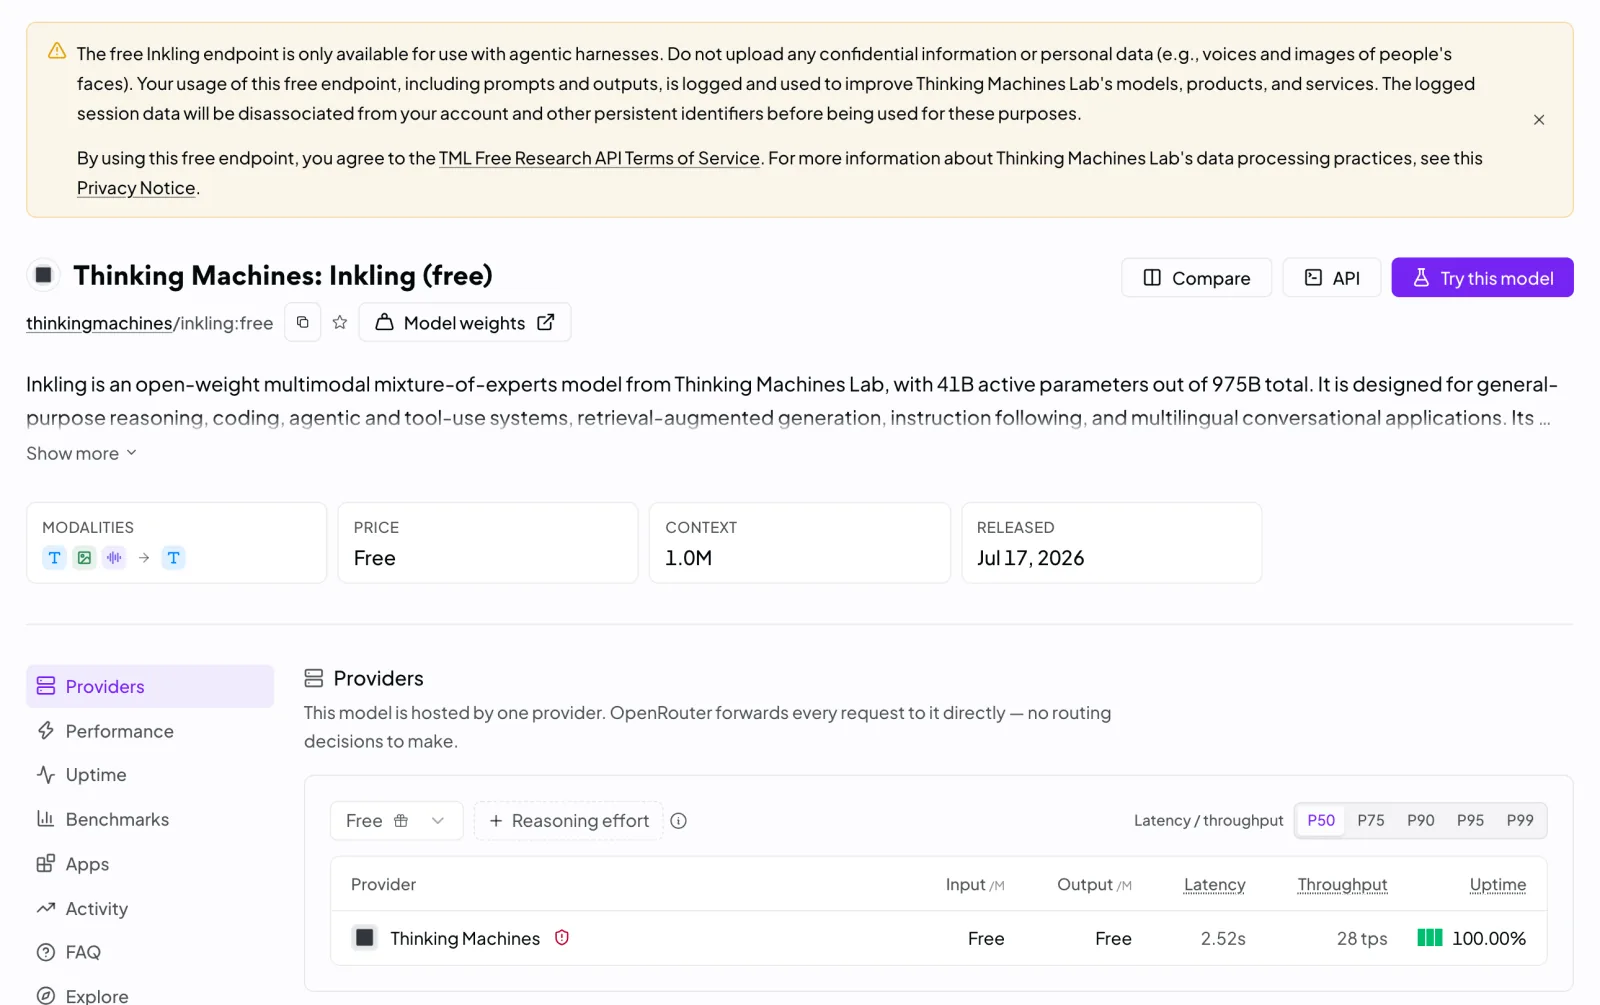
Captura: openrouter.ai/thinkingmachines/inkling:free, octubre de 2026.
Inkling es el modelo más grande de la lista gratuita. Thinking Machines Lab lo lanzó el 15 de julio de 2026, entrenado desde cero y con todos los pesos publicados: un Mixture-of-Experts con 975B parámetros en total y 41B activos, entrada de texto, imagen y audio, y hasta 1M tokens de contexto. Los pesos están en Hugging Face con licencia Apache 2.0. En OpenRouter, el endpoint gratuito sirve el contexto completo de 1M, mientras que la versión de pago ($1.00/M de entrada, $4.05/M de salida) se queda en 524K. El laboratorio es franco sobre dónde está: “Inkling no es el modelo más fuerte disponible hoy en general, ni abierto ni cerrado”, y lo presenta como una base para personalizar.
Lee el aviso de la parte de arriba de la página del modelo antes de integrarlo. El endpoint gratuito “solo está disponible para su uso con entornos agénticos”, y Thinking Machines registra sus prompts y respuestas para mejorar sus modelos, después de separarlos de tu cuenta. Úsalo para experimentos con agentes de programación, no para trabajo confidencial. Su hermano pequeño, thinkingmachines/inkling-small:free (276B en total, 12B activos), tambien es gratis.
NVIDIA Nemotron 3 Ultra (550B-A55B)
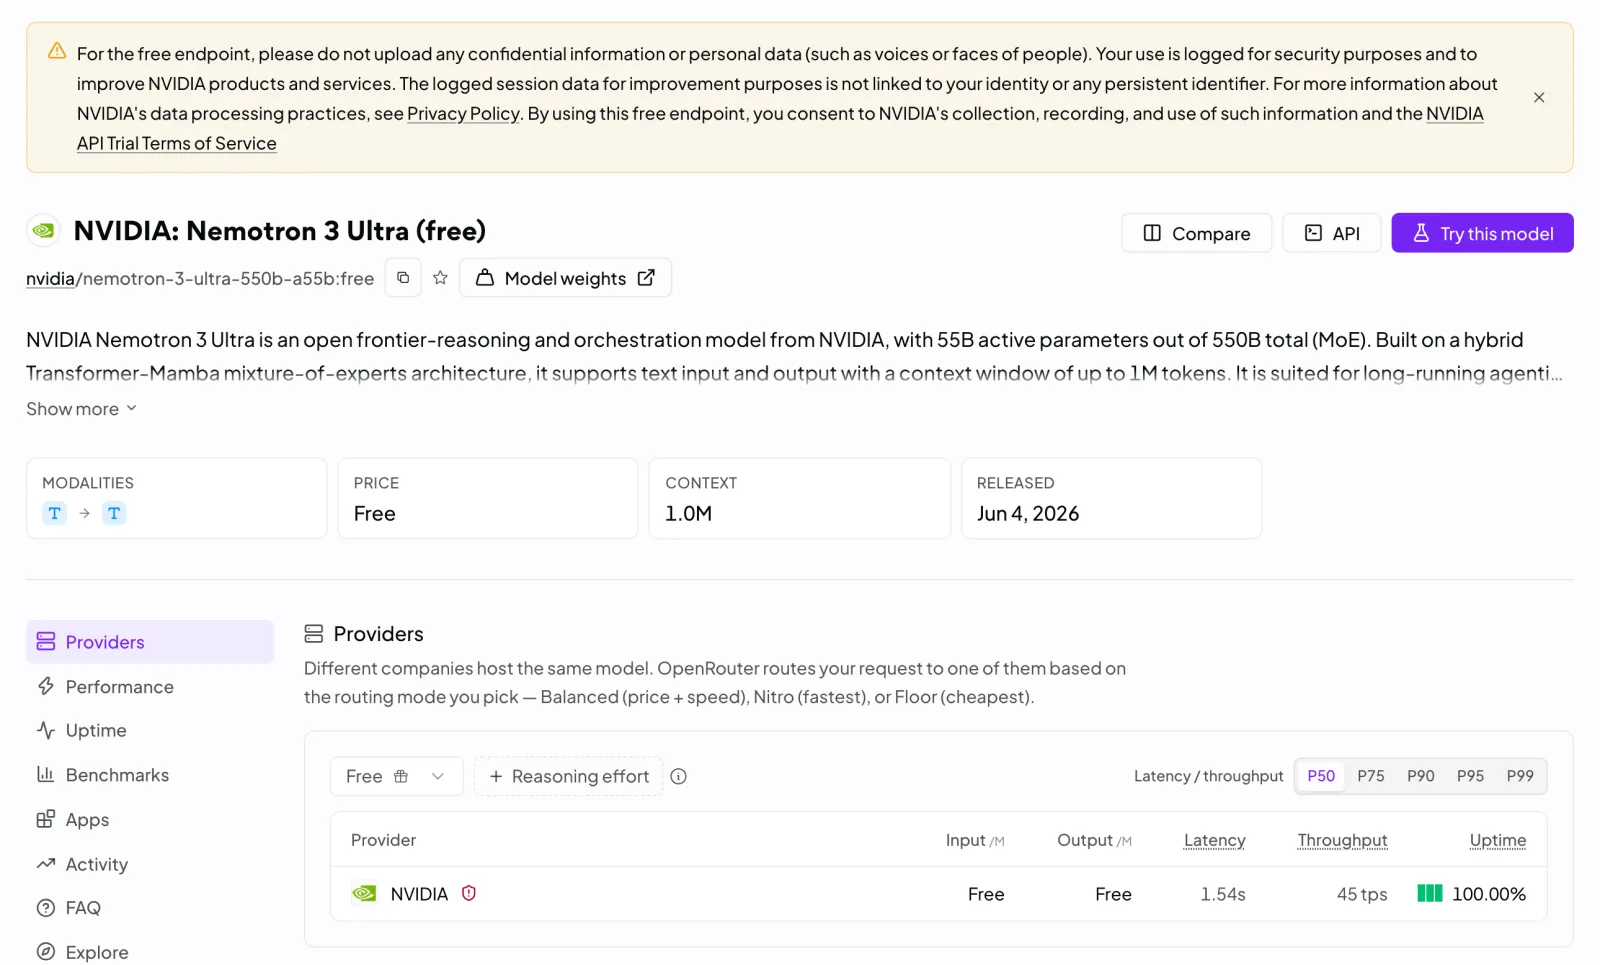
Captura: openrouter.ai/nvidia/nemotron-3-ultra-550b-a55b:free, octubre de 2026.
NVIDIA Nemotron 3 Ultra, lanzado el 4 de junio de 2026, es una de las dos elecciones de julio que siguen siendo gratis. Es un MoE de 550B parámetros con 55B activos por token, construido sobre una arquitectura híbrida Transformer-Mamba que NVIDIA diseñó para pipelines de agentes con mucho throughput. NVIDIA sirve el endpoint gratuito directamente, con un contexto de 1M tokens y hasta 65,536 tokens de salida. Los endpoints de pago, desde $0.40/M de entrada y $1.76/M de salida, se quedan en 262K de contexto, así que en este modelo el nivel gratuito es el más grande. El aviso de NVIDIA en la página dice que el uso del endpoint gratuito “se registra por motivos de seguridad y para mejorar los productos y servicios de NVIDIA”.
NVIDIA Nemotron 3.5 Super VL (120B-A12B)
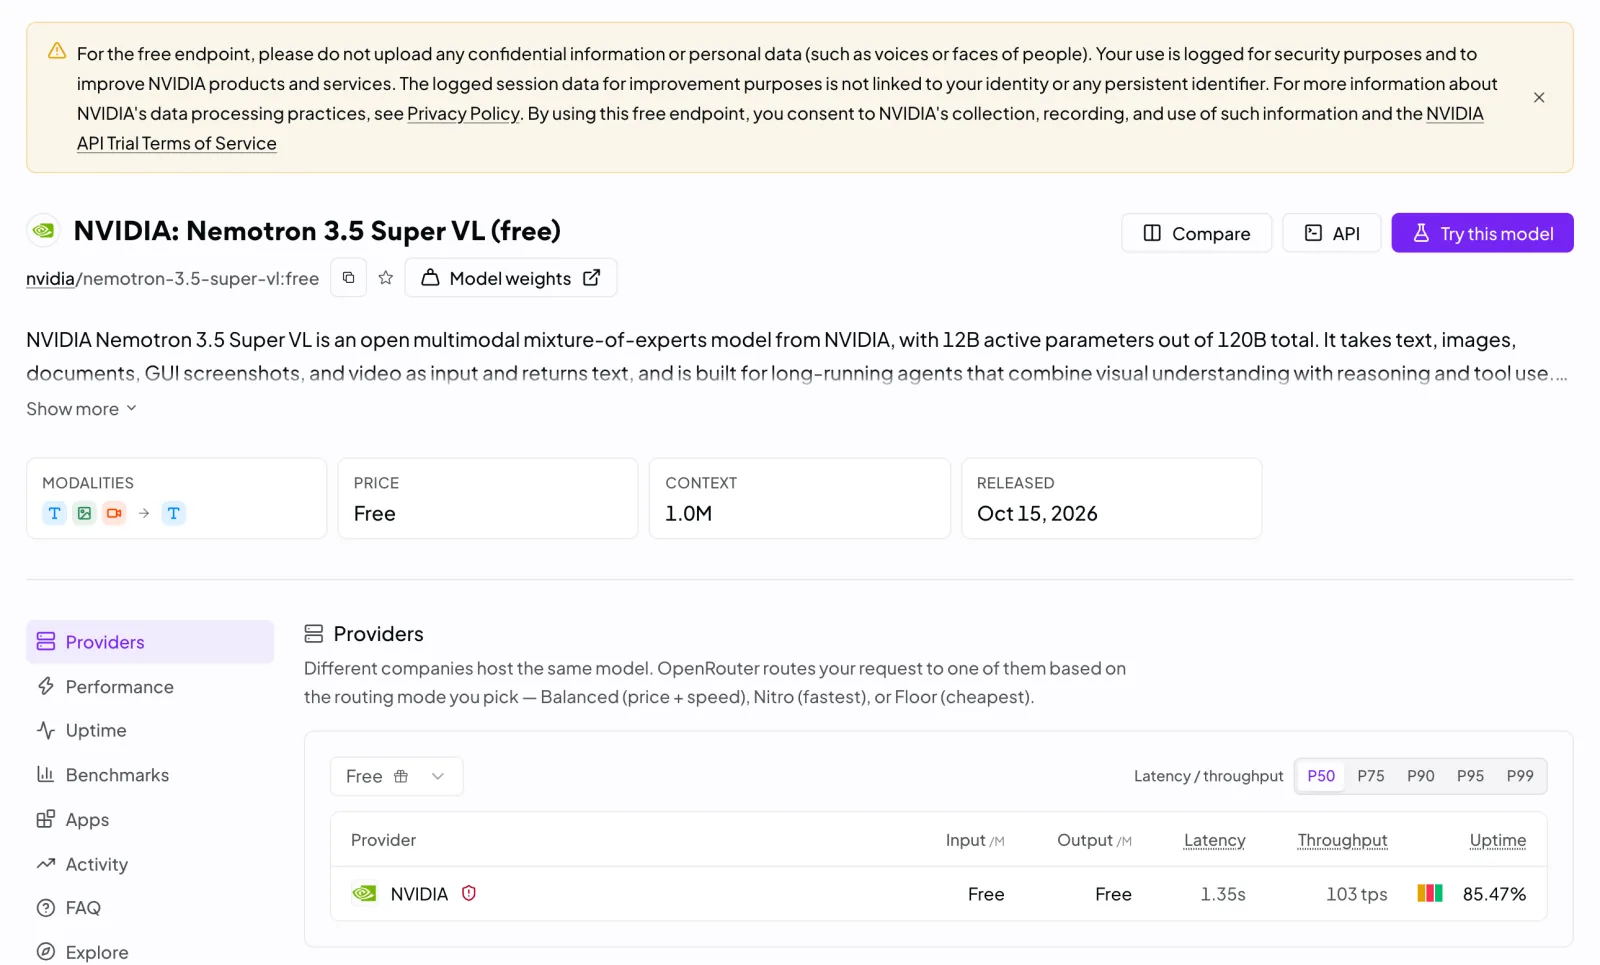
Captura: openrouter.ai/nvidia/nemotron-3.5-super-vl:free, octubre de 2026.
Nemotron 3.5 Super VL es el modelo más reciente de esta guía, lanzado el 15 de octubre de 2026. Es un MoE de 120B parámetros con 12B activos que acepta texto, imágenes, documentos, capturas de interfaces gráficas y vídeo y devuelve texto, con un contexto de 1M tokens y el razonamiento activado por defecto (puedes desactivarlo o darle un presupuesto de tokens). Eso lo convierte en la opción gratuita para extraer datos de documentos, agentes que trabajan sobre capturas de pantalla y comprensión de vídeo. En su página aparece el mismo aviso de registro de NVIDIA. Los endpoints de pago empiezan en $0.06/M de entrada. Si prefieres velocidad a tamaño, nvidia/nemotron-3.5-lightning:free (30B en total, 3B activos, solo texto, 1M de contexto) es la opción de alto throughput de la misma familia.
Google Gemma 4 (31B y 26B-A4B)
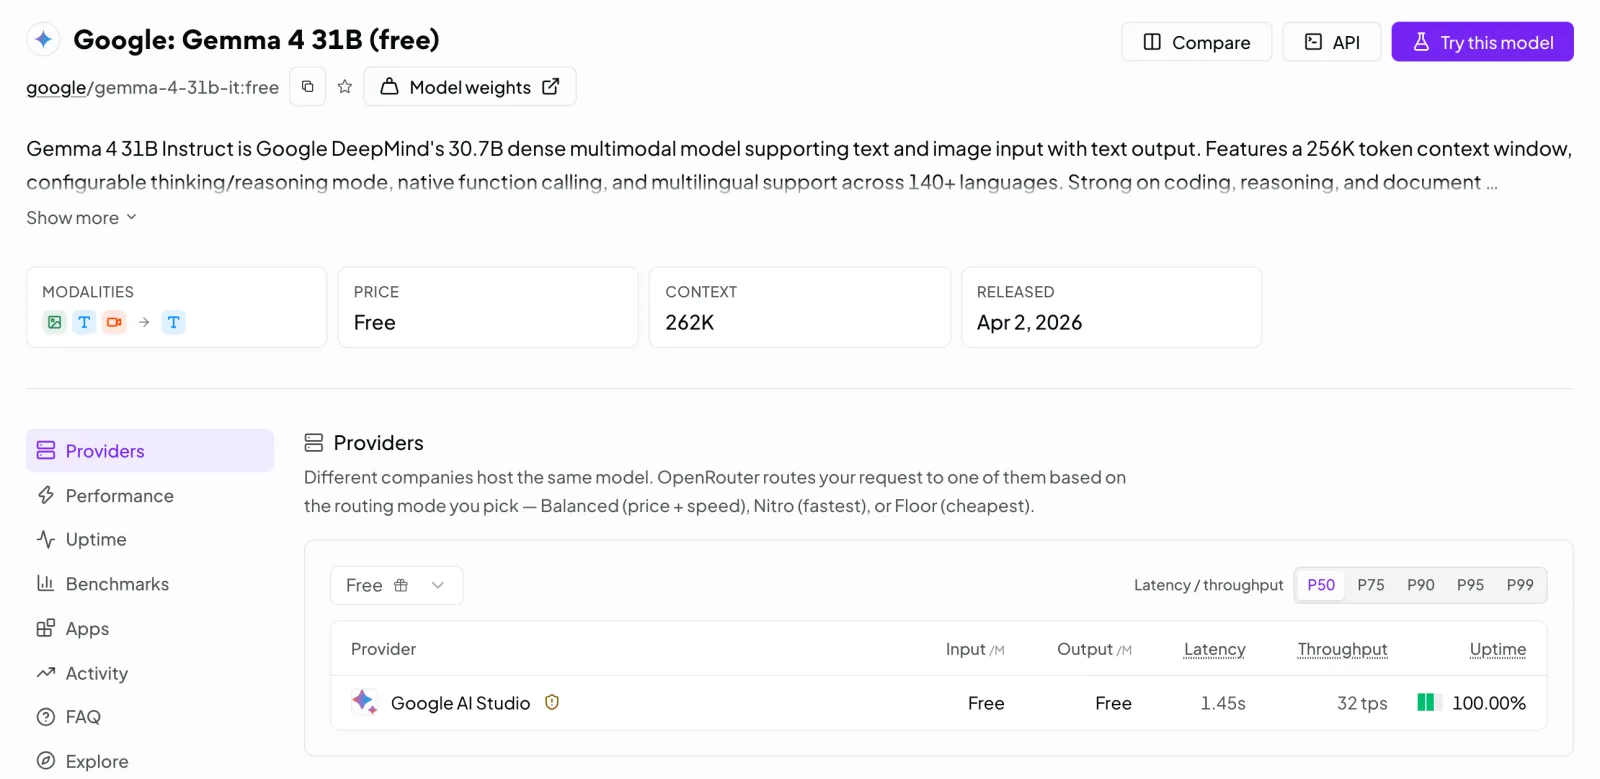
Captura: openrouter.ai/google/gemma-4-31b-it:free, octubre de 2026.
La familia Gemma 4 de Google DeepMind, lanzada el 2 de abril de 2026, es la otra elección de julio que sigue siendo gratis, y las dos variantes han sobrevivido. google/gemma-4-31b-it:free es el modelo denso de 30.7B: sin enrutado MoE, así que es el más lento de los dos, pero es el que conviene usar cuando quieres la mejor respuesta posible. `google/gemma-4-26b-a4b-it:free` es su hermano MoE, con 25.2B parámetros en total y 3.8B activos, y se queda cerca de la calidad del 31B respondiendo más rápido. Google AI Studio sirve los dos gratis con un contexto de 262K, hasta 32,768 tokens de salida, entrada de imagen y vídeo, razonamiento configurable, function calling nativo y más de 140 idiomas, con licencia Apache 2.0. A diferencia de las páginas de NVIDIA y Thinking Machines, la página gratuita de Gemma no muestra ningún aviso de registro.
Poolside Laguna S 2.1 - Se retira el 31 de octubre
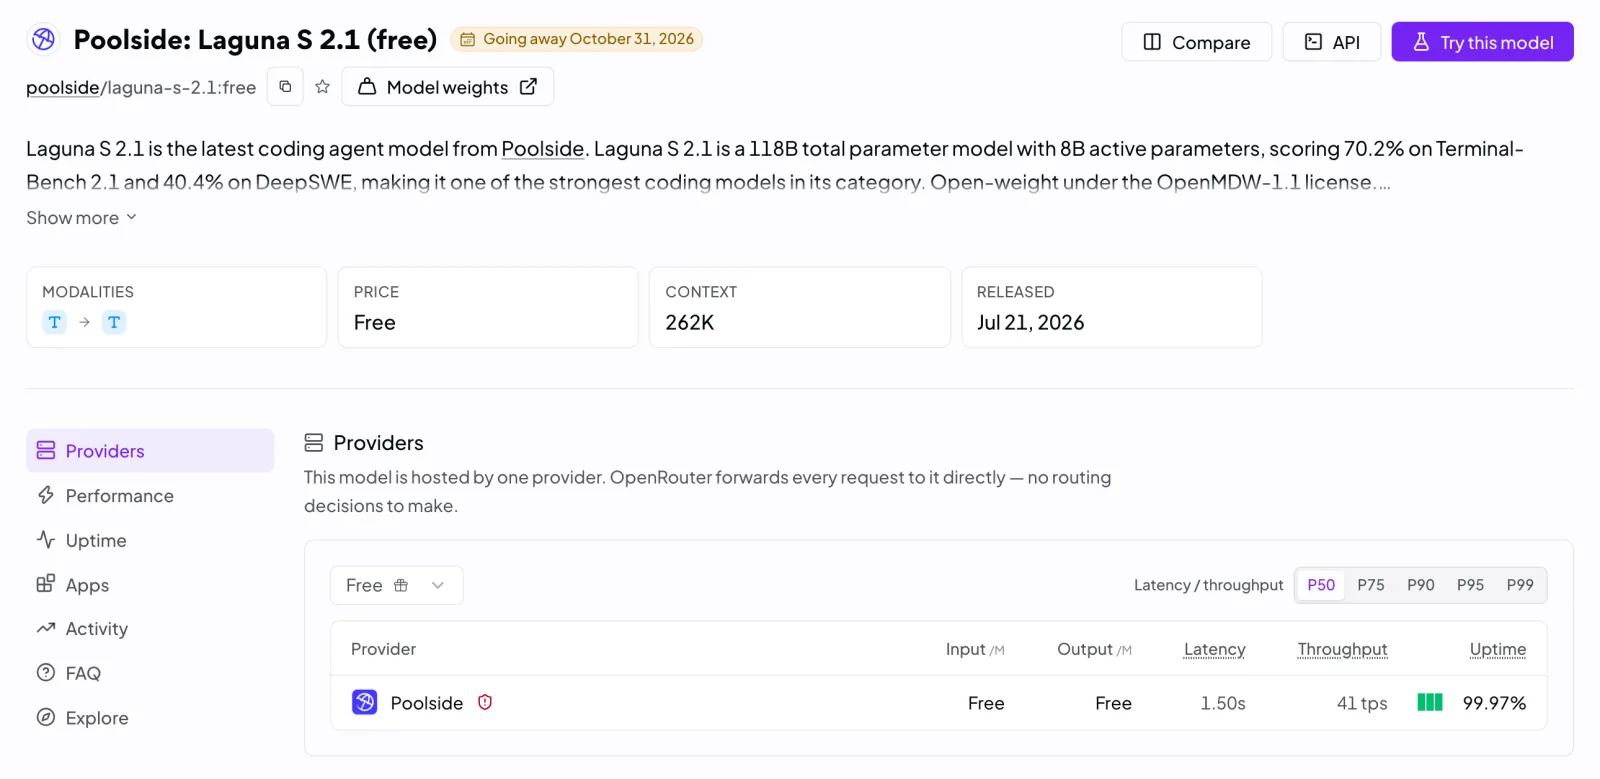
Captura: openrouter.ai/poolside/laguna-s-2.1:free, octubre de 2026.
Laguna S 2.1 es el modelo de Poolside para agentes de programación: 118B parámetros en total, 8B activos, de pesos abiertos con la licencia OpenMDW-1.1 y un contexto de 262K en el endpoint gratuito. Poolside publica un 70.2% en Terminal-Bench 2.1 y un 40.4% en DeepSWE. Son cifras del propio fabricante, pero buenas para un modelo con 8B parámetros activos, y de todo lo que hay en la lista gratuita es el más pensado para agentes de programación. Justo ahí está el problema: la página del modelo anuncia que se retira el 31 de octubre de 2026, y el más pequeño poolside/laguna-xs-2.1:free (33B en total, 3B activos) caduca el mismo día. Poolside también dice que puede usar las entradas y salidas del nivel gratuito para entrenar sus modelos. Y no es solo el nivel gratuito el que se acaba: la versión de pago ($0.09/M de entrada, $0.18/M de salida, 1M de contexto) muestra el mismo aviso de retirada para el 31 de octubre de 2026, igual que la versión de pago de Laguna XS 2.1.
Lo destacamos porque las listas de modelos gratuitos se quedan viejas en cuestión de semanas. Después del 31 de octubre de 2026, revisa su ficha actual antes de usarlo.
El resto del catálogo gratuito actual
Aparte de esos cinco, los modelos de chat gratuitos son Inkling Small; Nemotron 3.5 Lightning, Nemotron 3 Nano Omni (30B-A3B, con entrada de texto, imagen, audio y vídeo) y el modelo de guardrail Nemotron 3.5 Content Safety de 4B, todos de NVIDIA; North Mini Code de Cohere (30B, 3B activos), su primer modelo de programación agéntica; Flint de Recursive (40B, 2.5B activos), pensado para agentes de programación y añadido el 21 de octubre; Xing4.0 29B-A4B de China Telecom; Dots3-Note Preview de Dots Studio (280B, 16B activos), gratis hasta el 31 de diciembre de 2026; y LFM2.5-2.6B de LiquidAI para tareas pequeñas y rápidas. Fuera del chat hay modelos gratuitos de embeddings y reranking de NVIDIA y LiquidAI, y texto a voz gratuito de Fish Audio y HeyGen (el de HeyGen hasta el 30 de noviembre).
Si buscas modelos de pesos abiertos que puedas ejecutar en tu propio hardware en lugar de depender de un nivel gratuito que va rotando, mira nuestra guía de LLMs self-hosted para programar.
Qué hacen los endpoints gratuitos con tus prompts
Los límites de peticiones son el coste documentado del nivel gratuito. El menos evidente son los datos. Tres de las cinco páginas de modelo de arriba dicen que el proveedor registra el tráfico del nivel gratuito o puede entrenar con él: NVIDIA y Thinking Machines lo registran para mejorar sus modelos, y Poolside puede entrenar con él. Ese es el trato detrás de casi toda la inferencia gratuita: tú te llevas los tokens y el laboratorio se lleva uso real.
OpenRouter te deja excluirte, pero tiene un precio. La configuración de privacidad de tu cuenta tiene interruptores separados para modelos de pago y gratuitos que deciden si se permiten proveedores que pueden entrenar con tus datos, y según la documentación sobre registro de proveedores de OpenRouter, si te excluyes, “OpenRouter no enrutará a proveedores que entrenan”. Todos los modelos gratuitos de esta guía funcionan con un único proveedor, así que excluirte no te lleva a un host más seguro; directamente los deja fuera de tu cuenta. Si un modelo gratuito le funciona a todo el mundo menos a ti, revisa primero ese ajuste.
Nivel gratuito vs. pagar: a qué renuncias de verdad
El nivel gratuito no es una demo recortada. Los modelos gratuitos más grandes son lanzamientos de pesos abiertos a escala de frontera, y en Inkling y Nemotron 3 Ultra el endpoint gratuito ofrece una ventana de contexto mayor que la versión de pago. A esto renuncias si te quedas en lo gratuito:
- Modelos insignia propietarios. Los modelos gratuitos de OpenRouter son lanzamientos de pesos abiertos (Inkling, Nemotron, Gemma, Laguna) o promociones temporales. No vas a encontrar acceso gratuito a los modelos insignia de Claude, GPT o Gemini.
- Volumen. 50 o 1,000 peticiones al día bastan para proyectos personales y prototipos. No alcanza para una app en producción con tráfico real, y la propia OpenRouter avisa de que los modelos gratuitos pueden tener límites de peticiones o ir más lentos en horas punta.
- Privacidad. Como vimos arriba, muchos endpoints gratuitos registran lo que envías o pueden entrenar con ello.
Cuando se te quede corto, el pago por uso cobra el precio de lista de cada proveedor sin recargo sobre los tokens, más la comisión del 5.5% al comprar créditos. Si ya tienes keys de OpenAI, Anthropic o Google, BYOK (bring your own key, usar tu propia key) enruta a través de ellas sin comisión de OpenRouter sobre los primeros $25,000 de inferencia a precio de lista cada mes y con un 5% a partir de ahí, según la página de precios. Para gateways distintos de OpenRouter, nuestra comparativa de routers de LLM repasa Portkey, LiteLLM y otros, y nuestro artículo sobre los tropiezos de OpenRouter en producción cuenta qué se rompe cuando mueves tráfico de pago a OpenRouter.
Una forma realista de usar esto
El patrón que aguanta con el tiempo es este: desarrolla contra el endpoint compatible con OpenAI para no quedar atado nunca al SDK de un proveedor, pon dos o tres modelos gratuitos en un array de respaldo models en lugar de fiarte de uno solo, consulta free_model_daily_requests antes de las ejecuciones largas y deja los datos confidenciales en endpoints de pago cuya política de datos hayas leído. Trata los modelos stealth y las ofertas con fecha de caducidad como Laguna S 2.1 como capacidad extra, no como algo de lo que dependa un flujo de trabajo.
Conclusión
“API de IA gratis con tokens ilimitados” es una búsqueda llamativa, pero la descripción exacta resulta más útil una vez que la entiendes: OpenRouter te da acceso gratuito y sin tope por tokens a un conjunto bueno y cambiante de modelos de pesos abiertos (ahora mismo Inkling, Nemotron 3 Ultra, Nemotron 3.5 Super VL y Gemma 4), limitado por un número de peticiones diarias y no por tokens. Cincuenta peticiones al día no cuestan nada y no piden tarjeta; $10 en créditos, comprados una sola vez, lo suben a mil. La disciplina que exige no ha cambiado desde julio: diseña pensando en la rotación desde el primer día, lee el aviso sobre datos de cada endpoint gratuito y vuelve a revisar las páginas de los modelos antes de depender de ellos.