Cómo elegir el hardware adecuado para ejecutar LLMs en local en 2026
Actualizado el 29 oct 2026 · 19 min de lectura
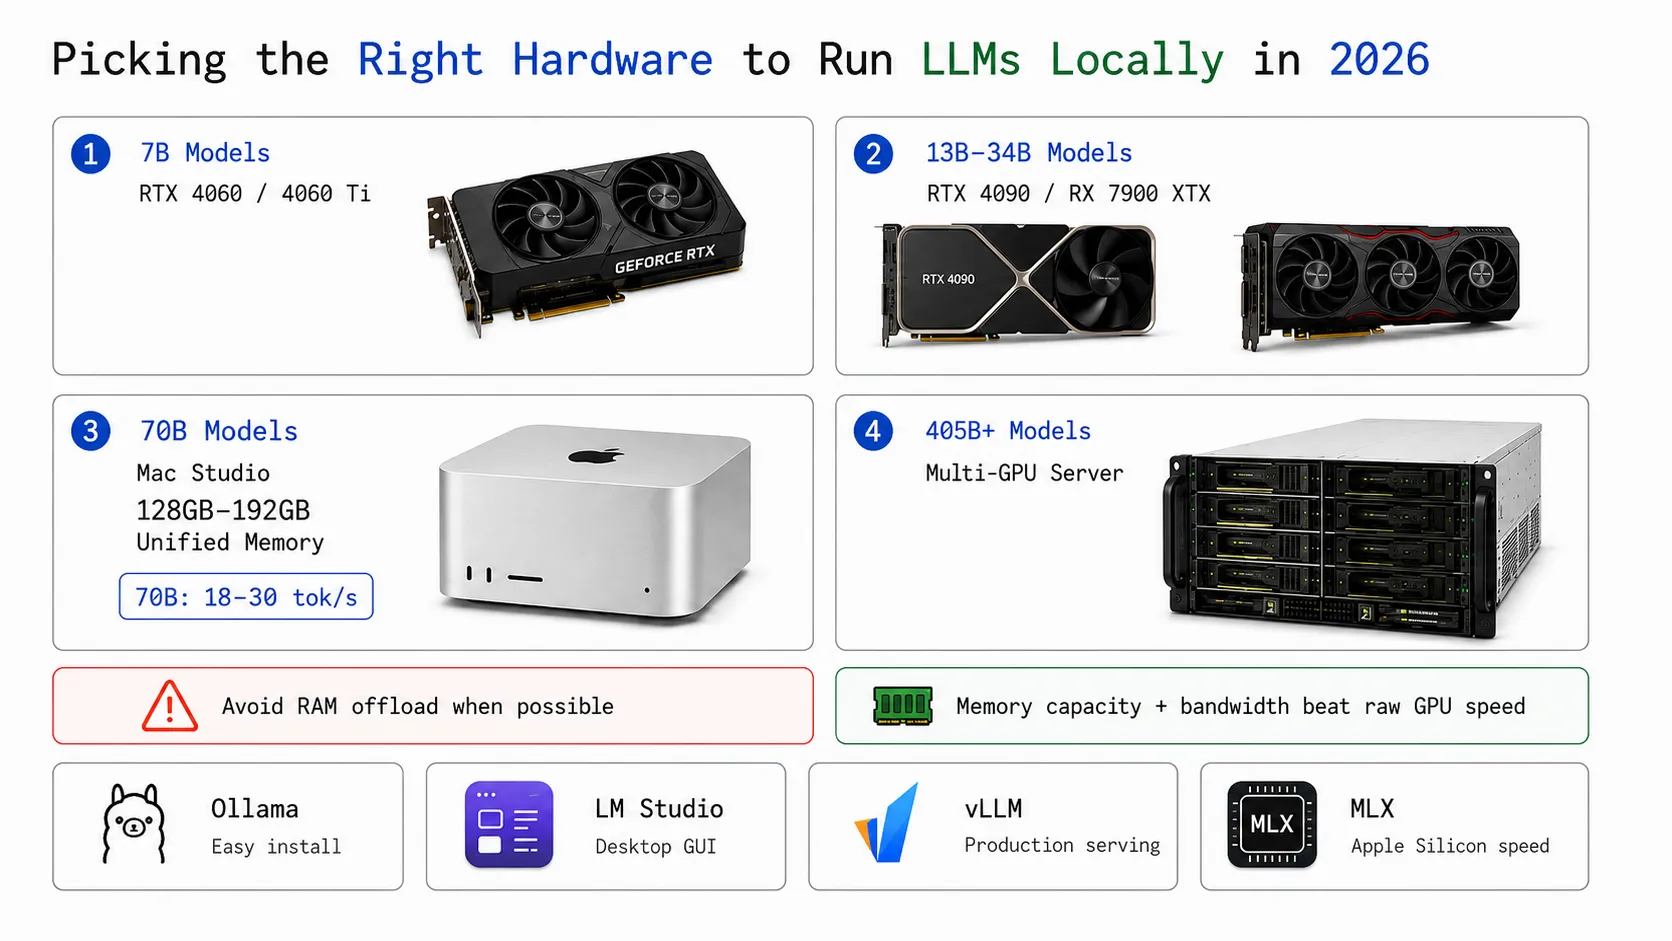
Ejecutar un LLM en local solía significar conformarse con algo que daba la sensación de estar escribiéndole a una licuadora. Eso ya no es así. Una GPU gaming de gama media mueve hoy Llama 3.3 70B a velocidades útiles de verdad para programar y trabajar con documentos, y en un Mac Studio con 192GB de memoria unificada cabe el mismo modelo a precisión completa, sin ninguna cuantización. La pregunta es simplemente qué hardware tiene sentido para lo que de verdad quieres ejecutar.
Esta guía cubre todos los niveles: desde una GPU de $340 para inferencia personal con modelos de 7B, pasando por los sistemas con mucha memoria unificada que cambiaron lo que se puede hacer en casa con modelos de 70B, hasta configuraciones empresariales con varias GPUs.
Resumen
Por tamaño de modelo:
- Modelos de 7B: RTX 5060 Ti 16GB (≈$500) o RTX 4060 8GB (≈$340)
- Modelos de 13B-34B: AMD RX 9070 XT 16GB (≈$670) o RTX 5080 16GB (≈$1,000)
- Modelos de 70B: sistemas AMD Ryzen AI Max+ 395 (desde ≈$1,500, 12-15 tok/s), Mac Studio M4 Max (desde ≈$2,600, 20-28 tok/s) o Mac Studio M3 Ultra 192GB (≈$3,999, 25-30 tok/s)
- 405B+: dos NVIDIA DGX Spark enlazados (≈$4,699) o un servidor multi-GPU
Regla clave: la capacidad y el ancho de banda de la memoria pesan más que la velocidad bruta de la GPU. Una tarjeta en la que cabe tu modelo entero gana a una más rápida que tiene que hacer offload a la RAM. Entre los sistemas de memoria unificada, lo que marca la diferencia es el ancho de banda: los sistemas AMD Ryzen AI Max+ 395 (~256 GB/s) llegan a 12-15 tok/s con 70B en Q4_K_M, mientras que el DGX Spark (273 GB/s) se queda en 2.7 tok/s ejecutando 70B en FP8 (una carga mucho más pesada). Apple Silicon (546-819 GB/s) va en cabeza con 20-30 tok/s.
El mejor software de inferencia:
- Ollama - se instala con un comando y funciona en todas partes; ahora usa MLX de forma nativa en Apple Silicon (v0.19+)
- LM Studio - la mejor interfaz gráfica para usuarios de escritorio
- vLLM - lo mejor para servir a varios usuarios en producción con NVIDIA
- MLX - API directa para inferencia en Apple Silicon; Ollama ya lo integra automáticamente
El cuello de botella: el ancho de banda de memoria
Antes de mirar hardware concreto, hay un concepto que conviene entender: la inferencia de LLMs está limitada por el ancho de banda de memoria, no por la capacidad de cómputo. Cada vez que el modelo genera un token, lee toda la matriz de pesos de la memoria una vez. La velocidad a la que puede hacerlo, en GB/s, es lo que determina los tokens por segundo, no los teraflops.
Por eso hay decisiones de hardware que parecen obvias sobre el papel y luego no salen como esperas. Una RTX 4090 tiene 1,008 GB/s de ancho de banda GDDR6X, el M3 Ultra tiene 819 GB/s y el DGX Spark, que se vende como un superordenador de IA personal, tiene 273 GB/s de LPDDR5X. Esa diferencia de ancho de banda es la razón de que el DGX Spark solo consiga 2.7 tok/s con Llama 3.1 70B (confirmado por el benchmark de Ollama de la propia NVIDIA), mientras que el M3 Ultra llega a 25-30 tok/s con el mismo modelo. La capacidad decide si el modelo cabe o no; el ancho de banda decide lo rápido que va una vez que cabe.
¿Cuánta memoria necesitas?
La cuantización GGUF te permite sacrificar un poco de calidad a cambio de gastar muchísima menos memoria. Q4_K_M es la recomendación estándar: más o menos la mitad de memoria que FP16, con una calidad que la mayoría de usuarios no sabe distinguir en la práctica.
| Tamaño del modelo | Q4_K_M | Q8_0 | FP16 |
|---|---|---|---|
| 7B | ~5 GB | ~8 GB | ~14 GB |
| 13B | ~9 GB | ~14 GB | ~26 GB |
| 34B | ~20 GB | ~34 GB | ~68 GB |
| 70B | ~42 GB | ~70 GB | ~140 GB |
| 405B | ~220 GB | ~405 GB | ~810 GB |
Un atajo rápido: model_size_B × 0.6 te da el requisito aproximado de Q4_K_M en GB. La ventana de contexto también añade memoria extra: un contexto de 128K puede casi duplicar el uso de memoria en modelos grandes.
GPUs de consumo
Las series RTX 40 y 50 de NVIDIA dominan esta categoría. El ecosistema (Ollama, LM Studio, vLLM, TensorRT-LLM, llama.cpp) apunta primero a CUDA, y esa madurez del software importa tanto como las especificaciones del hardware.
En la gama de entrada, la RTX 5060 Ti 16GB (≈$500) es la nueva recomendación económica para 2026: es una tarjeta Blackwell con soporte FP4, mueve 14B en Q8 con holgura y es más eficiente que sus predecesoras de la serie 40. La más antigua RTX 4060 8GB (≈$340) sigue a la venta y va bien con modelos de 7B a 40-60 tok/s, pero la 5060 Ti 16GB te da el doble de VRAM por no mucho más dinero.
En la gama media están la RTX 5080 16GB (≈$1,000 de MSRP, aunque en la práctica suele costar más) y la RTX 4090 24GB. Los 960 GB/s de ancho de banda GDDR7 de la 5080 son competitivos, pero sus 16GB de VRAM te limitan a 13B en Q8; los 24GB de la 4090 aguantan 20B o menos sin hacer offload. La 4090 es ahora más difícil de conseguir (NVIDIA dejó de fabricarla en octubre de 2024) y los precios en tienda rondan los $2,400-$3,500. Si encuentras una por debajo de $2,000, merece la pena; si no, la 5080 o una 4090 usada son las opciones prácticas. La RTX 4090 pasa de los 120 tok/s con modelos de 8B que caben enteros en VRAM. El problema es 70B: el modelo necesita unos 42GB y unos 18GB acaban en la RAM del sistema a través de PCIe, lo que deja la velocidad real de decodificación con Llama 3.1 70B en 8-18 tok/s.
La RTX 5090 32GB (≈$3,000-5,000, nunca se ha vendido cerca de su MSRP de $2,000) tiene 1,792 GB/s de ancho de banda GDDR7 y carga 34B en Q8 entero en VRAM. A los precios actuales del mercado, cuesta recomendarla frente a dos tarjetas más baratas o un Mac Studio en la mayoría de configuraciones.
Si vas con presupuesto ajustado, una RTX 3090 usada ($800-1,050) te da 24GB de VRAM con aproximadamente el 87% del rendimiento de la 4090. Los precios de segunda mano han subido respecto al año pasado, pero sigue siendo la opción de 24GB mas práctica por debajo de $1,000.
AMD tiene dos buenas opciones en 2026. La RX 9070 XT (16GB GDDR6, ≈$500 de MSRP) es la recomendación más clara: arquitectura RDNA 4, soporte oficial de ROCm desde el lanzamiento y la tarjeta AMD más segura para trabajar con LLMs en Linux. La más antigua RX 7900 XTX (24GB) ha subido a ≈$800 usada / $1,339 nueva, lo que le resta atractivo. ROCm 7.2 añadió soporte FP8 para ambas tarjetas, y Ollama, LM Studio y llama.cpp funcionan bien. El soporte en Windows sigue siendo irregular: para inferencia con AMD, Linux es claramente preferible.
Sistemas con mucha memoria unificada
Esta es la categoría que cambia las cuentas para los modelos de 70B. En un PC normal con una GPU de 24GB no puedes cargar un modelo de 70B sin hacer offload a la RAM y llevarte un buen golpe de velocidad. Los sistemas con mucha memoria unificada, en los que CPU, GPU y motor neuronal comparten el mismo bloque de memoria, eliminan ese techo por completo. Carga un modelo de 70B en Q8 en 96GB de memoria unificada y todas las capas se ejecutan a la velocidad del bus de memoria.
La conclusión clave de los benchmarks: la capacidad te dice si el modelo cabe; el ancho de banda te dice lo rápido que va. Los sistemas de abajo van de 128GB a 192GB de memoria unificada y de ~256 GB/s a 819 GB/s de ancho de banda, y por eso los tokens por segundo con el mismo modelo de 70B varían más de 10x entre ellos.
| Sistema | Memoria | Ancho de banda | tok/s con Llama 70B | tok/s con 8B | Precio |
|---|---|---|---|---|---|
| Mac Studio M3 Ultra (192GB) | 192 GB unificada | 819 GB/s | 25-30 (Ollama/MLX) | ~80 | desde $3,999 (96GB de base) |
| Mac Studio M4 Max (128GB) | 128 GB unificada | 546 GB/s | 20-28 (Ollama/MLX) | ~60 | desde $3,200 |
| AMD Ryzen AI Max+ 395 (Strix Halo, hasta 128GB) | hasta 128 GB unificada | ~256 GB/s | 12-15 (Q4_K_M, ROCm) | ~50-60 | desde ~$1,999 (sistema) |
| AMD Ryzen AI Max+ 495 (Gorgon Halo, hasta 192GB) | hasta 192 GB unificada | ~256 GB/s | Por confirmar - T3 2026 | Por confirmar | T3 2026 |
| NVIDIA RTX Spark (hasta 128GB) - próximamente | hasta 128 GB LPDDR5X | ~300 GB/s | Por confirmar - otoño de 2026 | Por confirmar | Otoño de 2026 |
| NVIDIA DGX Spark (128GB) | 128 GB LPDDR5X | 273 GB/s | 2.7 (FP8, confirmado por Ollama) | ~924 (NIM/FP4) | $4,699 |
| RTX 4090 (24GB) - como referencia | 24 GB GDDR6X | 1,008 GB/s | 8-18 (con offload a CPU) | ~120-128 | $2,400-3,500 |
Mac Studio M4 Max (128GB)
El M4 Max ofrece 546 GB/s de ancho de banda y 20-28 tok/s con Llama 3.3 70B, mejor que una 4090 con 70B, no porque Apple Silicon sea más rápido, sino porque el modelo cabe entero en memoria sin offload. Ejecuta 70B en Q4 o 32B en Q8 con margen de sobra, consume 200-400W en total (frente a los 350W de la GPU 4090 sola) y además sirve como estación de trabajo diaria, silenciosa y capaz. Las configuraciones de 64GB o 96GB empiezan en torno a $2,200-$2,600.
Desde Ollama 0.19 (marzo de 2026), Ollama en Apple Silicon usa MLX como backend de inferencia, así que ya no tienes que elegir entre los dos: Ollama te da el rendimiento de MLX automáticamente.
Mac Studio M3 Ultra (192GB)
El M3 Ultra es la opción con más memoria unificada en una sola máquina que existe fuera del hardware empresarial. Sus 819 GB/s de ancho de banda llevan la velocidad de decodificación a 25-30 tok/s con 70B, en el mismo rango que una H100 para inferencia de un solo usuario y por una fracción del coste. En 192GB cabe Llama 3.3 70B a precisión BF16 completa (140GB) con margen, o 405B en Q2. El Mac Studio con M3 Ultra empieza en $3,999 (configuración base de 96GB; los 192GB son una opción BTO).
La contrapartida que conviene conocer: MLX todavía no ofrece la eficiencia de batching que vLLM da en hardware NVIDIA. Sirviendo a 20 usuarios a la vez, una H100 se pone claramente por delante. Para un desarrollador o un equipo pequeño, el Mac Studio sale mucho más a cuenta.
NVIDIA DGX Spark (128GB LPDDR5X)
El DGX Spark salió a $4,699 como el “superordenador de IA personal” de NVIDIA: un Grace Blackwell Superchip con 128GB de memoria unificada, 1 petaFLOP de rendimiento de IA y Ollama y TensorRT-LLM preinstalados. Con modelos pequeños, los tensor cores Blackwell son excepcionales: unos 924 tok/s con Llama 3.1 8B vía NVIDIA NIM en FP4. Esa cifra es real e impresionante.
Con 70B, el bus LPDDR5X a 273 GB/s se convierte en el techo. El benchmark oficial de Ollama de la propia NVIDIA registra 2.7 tok/s con Llama 3.1 70B FP8. No es un fallo de configuración: es lo que sale de leer unos 42GB de pesos del modelo a través de una tubería de 273 GB/s, una vez por token. Los tensor cores Blackwell pasan la mayor parte del tiempo parados porque no se les puede alimentar lo bastante rápido.
Así que el DGX Spark sí es la opción correcta si necesitas compatibilidad con CUDA, contenedores NVIDIA NIM, flujos de fine-tuning o inferencia con modelos de menos de 8B a muy alto throughput. Para inferencia interactiva con 70B, un Mac Studio M3 Ultra cuesta menos y va 10 veces más rápido. Dos DGX Spark enlazados por 10 GbE (≈$4,699) sí cubren modelos de 405B en Q2-Q3 mediante inferencia distribuida, algo que de otro modo es imposible a este precio. Las versiones OEM de Dell, ASUS, Acer y MSI salen a precios parecidos y con otros formatos.
AMD Ryzen AI Max+ 395 (Strix Halo)
El Ryzen AI Max+ 395 es la respuesta de AMD a Apple Silicon para inferencia local de LLMs: una APU monolítica con 16 núcleos de CPU Zen 5, 40 compute units RDNA 3.5 (Radeon 8060S) y una NPU XDNA 2 de más de 50 TOPS, todo compartiendo hasta 128GB de memoria unificada LPDDR5X. Hasta 96GB de esa memoria se pueden asignar como VRAM con AMD Variable Graphics Memory, lo que significa que puedes cargar un modelo de 70B en Q4_K_M (~42GB) entero en la GPU sin ningún offload a CPU, algo que ninguna tarjeta dedicada de 24GB puede hacer.
Los benchmarks reales de las pruebas de la comunidad (Framework Desktop, Corsair AI Workstation 300, ASUS ROG Flow Z13) se sitúan en 12-15 tok/s con Llama 3.3 70B Q4_K_M con un stack de ROCm bien configurado, y en torno a 50-60 tok/s con modelos de 8B. Es más lento que un Mac Studio M4 Max, pero bastante más rápido que cualquier GPU de 24GB haciendo offload a CPU, y el hardware empieza en torno a $1,500 en kits de mini-PC barebone, muy por debajo de cualquier opción de Apple Silicon.
El problema es la madurez del software. ROCm es imprescindible para inferencia acelerada por GPU por encima de 30B parámetros: sin él, Ollama tira por defecto solo de CPU y el rendimiento se hunde. ROCm 7.x funciona de forma fiable en Linux; en Windows es irregular y no se recomienda para trabajo serio con LLMs en Strix Halo. Con ROCm bien instalado, Ollama, LM Studio y llama.cpp funcionan bien. Un consejo práctico: define HSA_OVERRIDE_GFX_VERSION=11.0.0 si tu distro trae un ROCm antiguo que no reconoce la 8060S.
Hay sistemas Strix Halo en varios formatos: portátiles (ASUS ROG Flow Z13, ASUS ProArt PX13), mini-PCs y sobremesas pequeños (Framework Desktop, Minisforum AI370, Corsair AI Workstation 300) y la propia plataforma para desarrolladores Ryzen AI Halo de AMD (disponible en Micro Center, con reservas desde junio de 2026). Si te manejas bien con Linux y con la configuración de ROCm, esta es la vía más asequible para tener inferencia cómoda con 70B.
AMD Ryzen AI Max+ 495 (Gorgon Halo)
La generación Gorgon Halo mejora la plataforma Strix Halo en dos aspectos importantes: capacidad de memoria y frecuencias de GPU. El tope de gama, el Ryzen AI Max+ 495, combina 16 núcleos de CPU Zen 5 (hasta 5.2 GHz) con una Radeon 8065S de 40 CU (RDNA 3+) y admite hasta 192GB de memoria unificada, de los que 160GB se pueden asignar como memoria de GPU dedicada. Es margen suficiente para Llama 3.3 70B a precisión BF16 completa (~140GB), o para modelos de más de 300B parámetros con cuantización Q4.
El 495 es alrededor de un 10% más rápido que el 395 en cargas de CPU y tiene una frecuencia de GPU algo más alta (3.0 GHz). El subsistema de memoria sigue siendo LPDDR5X, así que el ancho de banda máximo se queda en el mismo rango de ~256 GB/s: no esperes muchos más tok/s que con un 395 para el mismo tamaño de modelo. Lo que aporta es el margen extra: puedes ejecutar modelos con más precisión sin que la cuantización les recorte calidad.
La gama Gorgon Halo (serie Ryzen AI Max PRO 400) se presentó en mayo de 2026 y está previsto que llegue en equipos de ASUS, HP y Lenovo en el tercer trimestre de 2026. La plataforma para desarrolladores Ryzen AI Halo de nueva generación de AMD (un mini-PC) también recibirá una versión Gorgon Halo en el tercer trimestre. El precio de los sistemas de consumo no está confirmado; cuenta con que costarán más que las configuraciones Strix Halo equivalentes por la mejora de memoria.
NVIDIA RTX Spark (llega en otoño de 2026)
Anunciado en Computex 2026, el RTX Spark es la respuesta de NVIDIA a Apple Silicon y al Strix Halo de AMD: un superchip de un solo chip que combina una CPU Arm de 20 núcleos (desarrollada con MediaTek) y una GPU Blackwell con 6,144 núcleos CUDA en un encapsulado de 3nm de TSMC, con hasta 128GB de memoria unificada LPDDR5X y ~300 GB/s de ancho de banda.
La propuesta está clara: portátiles Windows finos (14mm, ~3 lbs, modelos OLED de 14" y 16") con todo el ecosistema CUDA, 1 PFLOP de rendimiento de IA en FP4 y la capacidad de ejecutar en local modelos de más de 120B parámetros. Es el primer intento serio de llevar la idea del DGX Spark (memoria CUDA unificada para inferencia local de LLMs) al formato de portátil de consumo.
Con modelos pequeños, los tensor cores Blackwell con soporte FP4 deberían dar un throughput muy alto, parecido a los impresionantes 924 tok/s del DGX Spark con 8B vía NIM. Para inferencia con 70B, el ancho de banda LPDDR5X de ~300 GB/s es la misma limitación que tiene el DGX Spark, así que espera un rendimiento de un orden parecido con modelos grandes. Los benchmarks reales tendrán qeu esperar al lanzamiento. Está previsto que los portátiles y sobremesas pequeños con RTX Spark lleguen en otoño de 2026 de la mano de ASUS, Dell, HP, Lenovo, Microsoft Surface y MSI.
GPUs profesionales y empresariales
Cuando das servicio a un equipo en lugar de a un solo usuario, las GPUs de consumo se topan con límites reales: no tienen memoria ECC, las garantías son más cortas y el software está probado sobre todo para cargas de un solo usuario. El nivel profesional resuelve todo eso.
La tarjeta profesional actual para estaciones de trabajo es la RTX PRO 6000 Blackwell (96GB GDDR7 ECC, ≈$8,565), que sustituyó a la RTX 6000 Ada en marzo de 2025. Con 96GB cabe 70B en Q8 entero en VRAM, y la arquitectura Blackwell añade soporte FP4 y 2.5x más rendimiento en entrenamiento de IA que Ada. La más antigua RTX 6000 Ada (48GB GDDR6 ECC, ≈$6,800) sigue siendo una tarjeta capaz a un precio más bajo si encuentras una: carga 70B en Q4_K_M en VRAM y se maneja bien sirviendo a varios usuarios con vLLM. La L40S (48GB, ≈$7,500-10,000 nueva) ocupa el mismo nivel de 48GB pero está pensada para centros de datos, con alquiler en la nube en torno a $0.50-7.58 por hora.
La H100 SXM (80GB HBM3, 3.35 TB/s) es donde viven las cargas de producción. La inferencia de 70B con un solo flujo ronda los 25 tok/s, pero la ventaja real es el throughput concurrente con vLLM: docenas de usuarios compartiendo una GPU sin que la velocidad caiga en proporción. El hardware H100 SXM cuesta ahora $35,000-40,000 por tarjeta; en la nube, el precio va de $1.99 a $8 por hora. La H200 (141GB HBM3e, 4.8 TB/s) lleva esto a modelos como DeepSeek V3.2 671B en Q2, que necesita nodos de 8x H200.
Almacenamiento, RAM y multi-GPU
Unos cuantos puntos prácticos que se suelen subestimar.
La RAM del sistema hace de desbordamiento cuando se llena la VRAM de la GPU. Ejecutar un modelo de 70B de 42GB en una tarjeta de 24GB significa que unos 18GB pasan a la RAM por PCIe. Si la RAM también se queda corta, las capas acaban en el disco y la latencia pasa de segundos a minutos. Pon como mínimo el doble de tu VRAM en RAM del sistema: 64GB es el mínimo para una configuración con 4090, y con 128GB vas más cómodo.
El almacenamiento marca el tiempo de carga del modelo. Un modelo de 70B en Q4 ocupa unos 40GB en disco. Un NVMe PCIe 4.0 (Samsung 990 Pro, WD Black SN850X, unos 7,000 MB/s) lo carga en 5-10 segundos. Un SSD SATA a 550 MB/s tarda más de un minuto. Hazte con al menos 2TB de NVMe PCIe 4.0, o 4TB si piensas tener varios modelos grandes a mano.
El multi-GPU te da VRAM sumada, algo que importa con modelos que no caben en una sola tarjeta. Dos RTX 4090 suman 48GB, suficiente para 70B en Q8, pero la interconexión PCIe entre tarjetas de consumo deja la eficiencia de escalado en solo un 70-78%. Obtienes más o menos 1.4-1.5x de throughput, no 2x. Las tarjetas profesionales con NVLink (RTX 6000 Ada, A100, H100) escalan mejor, con un 85-93% por cada tarjeta que añades.
Nube vs. hardware propio
Para un uso esporádico, alquilar gana con facilidad. Un equivalente a una RTX 4090 en un proveedor de nube descentralizado cuesta $0.29-1.00 por hora, mucho menos que comprar hardware que usarías unas pocas horas a la semana.
Las cuentas cambian con una utilización sostenida. Un equipo que gasta $5,000 al mes en inferencia con GPUs en la nube paga $60,000 al año. Un par de RTX 4090 por ≈$3,400 se amortiza en menos de dos meses a ese ritmo de gasto. La regla general: por debajo de un 70% de utilización sostenida, la nube sale más barata a tres años. Por encima del 80%, el hardware propio suele amortizarse en un plazo de cuatro a doce meses.
Primeros pasos con Ollama
Una vez que tienes el hardware, poner en marcha un modelo lleva menos de cinco minutos. Instala Ollama:
curl -fsSL https://ollama.com/install.sh | shDescarga y ejecuta un modelo. En un sistema con 128GB o más de memoria unificada, Llama 3.3 70B cabe sin offload:
ollama pull llama3.3:70b
ollama run llama3.3:70b
Para una GPU de 12-16GB, Qwen3 14B es más adecuado:
ollama pull qwen3:14b
ollama run qwen3:14b
Ollama usa tu GPU automáticamente (NVIDIA, AMD o Apple Silicon) y expone una API compatible con OpenAI en localhost:11434. Apunta Cursor, Continue.dev u Open WebUI a ese endpoint y listo. En Apple Silicon, Ollama 0.19+ usa MLX como backend automáticamente, sin tener que configurar MLX por separado.
Como frontend de chat, Open WebUI se ejecuta en Docker:
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  --name open-webui \
  ghcr.io/open-webui/open-webui:main
Eso te da una interfaz al estilo de ChatGPT en localhost:3000. Nuestra guía de alternativas open source a ChatGPT repasa más opciones de frontend si quieres algo más que lo básico.
Accede a tu LLM desde cualquier lugar con Pinggy
Con Ollama funcionando en local, puede que quieras llegar a él desde otro dispositivo o compartirlo con alguien de tu equipo. Pinggy crea un túnel público seguro con un solo comando SSH, sin reglas de firewall, redirección de puertos ni IP estática.
ssh -p 443 -R0:localhost:11434 free.pinggy.io
Esto te da una URL HTTPS pública para tu instancia de Ollama. El mismo método sirve para Open WebUI en el puerto 3000 o para cualquier otro frontend de IA local.
Conclusión
Para modelos de 7B-34B, las GPUs de NVIDIA son la opción con mejor relación calidad-precio: la RTX 5060 Ti 16GB a $500 es el nuevo punto de entrada y la RTX 4090 (24GB) es el techo si consigues una. Para 70B en una sola máquina, el AMD Ryzen AI Max+ 395 (~$1,500) carga el modelo completo en memoria unificada a 12-15 tok/s; el Mac Studio M4 Max o M3 Ultra es más rápido (20-30 tok/s) y no necesita configurar ningún driver, solo que a un precio más alto. El DGX Spark y el RTX Spark son interesantes, pero el ancho de banda los limita para un uso interactivo con 70B.
Para saber qué ejecutar de verdad en este hardware, consulta la guía de los mejores LLMs open source para programar y la de las mejores herramientas de LLM locales para comparar software de inferencia.