Las mejores alternativas open source a Jev: 5 modelos de decisión autoalojados
Actualizado el 29 oct 2026 · 13 min de lectura
La mayoría de las decisiones que el software le pide a un modelo son pequeñas y repetitivas: enruta este ticket, marca este mensaje, valora esta gravedad. Esas llamadas nunca necesitaron prosa, y pagarle a un modelo de frontera para que genere una frase que acto seguido vuelves a parsear en un if siempre ha sido la herramienta equivocada para el trabajo.
TypeSafe lanzó Jev el 15 de septiembre de 2026 para hacer exactamente ese trabajo y nada más, y lo mantuvo cerrado, alojado y detrás de una lista de espera. Las primeras reimplementaciones abiertas aparecieron en unas 24 horas, AINews contó seis clones en dos días el 19 de septiembre, y la lista awesome-jev ya recoge más de una docena. El más grande tiene 19,301 estrellas en GitHub, y sumó más de 5,000 solo en el último día.
Abajo están los cinco que merecen tu tiempo, ordenados por estrellas de GitHub sacadas de la API el 23 de septiembre de 2026. Dos de ellos los ejecuté en un Apple M3 Pro mientras escribía esto.
Resumen
El ecosistema abierto reproduce bien la interfaz de Jev, y su precisión solo en parte.
- Laya (19,301 estrellas, Apache-2.0): 421M sobre ModernBERT-large,
pip install laya, 32.8-39.5 ms por pregunta en una T4. Sus checkpoints base puntúan cerca del azar en zero-shot, así que es una base para hacer fine-tuning, no un reemplazo directo. - Kev (5,385 estrellas, Apache-2.0): adaptadores LoRA sobre Qwen3.5 en 0.8B, 4B y 9B, que sirven el contrato
/v1/systemonede TypeSafe para que el SDK oficial funcione sin cambios. Su nuevo backend MLX respondió en 47 ms en mi Mac. - SemIf (4,023 estrellas, MIT) no entrena ningún modelo: lee los logits de las opciones de un Qwen3.5-4B congelado, y mide 1.023 s frente a 5.332 s para las mismas 21 decisiones mediante JSON generado.
- NanoJev (2,086 estrellas, MIT) es un modelo de 0.6B para bucles de control en tiempo real, que gana a Jev por 128/128 frente a 56/128 en ViZDoom Basic. No es un clasificador general.
- jevlike (1,255 estrellas, MIT) trae un entrenador, no un modelo: aportas tus opciones etiquetadas y entrenas una cabeza de option-attention en un portátil.
- La advertencia: en el benchmark independiente de clasificadores con 49 tareas, Jev saca 0.966 de macro accuracy frente a 0.704 del mejor participante abierto. Estos proyectos ganan en latencia, precio y control, no en precisión de serie.
Por qué aparecieron una docena de clones en una semana
Un modelo System One es estrecho, y eso es justo lo que lo hizo fácil de copiar. Le pasas un bloque de estado más preguntas con tipos de respuesta declarados - un Choice entre hasta 255 opciones, un Score en una escala ordenada, una probabilidad sí/no Noul - y rellena todas las respuestas en una sola pasada en paralelo, en lugar de decodificar tokens. Nada que parsear, nada que reparar.
Esa interfaz es pública en la documentación de la API de TypeSafe; el modelo y los datos de entrenamiento no. Reproducir el contrato lleva un fin de semana, porque leer los logits de las opciones de cualquier modelo de pesos abiertos da una respuesta con la misma forma. Reproducir la calidad es un problema de investigación, y una semana no da para tanto.
Tabla comparativa
| Proyecto | Estrellas | Licencia | Qué ejecuta | Ideal para |
|---|---|---|---|---|
| Laya | 19,301 | Apache-2.0 | ModernBERT-large 421M, mmBERT-base 322M | Triaje que corre bien en CPU, 100+ idiomas |
| Kev | 5,385 | Apache-2.0 | Qwen3.5 0.8B / 4B / 9B + LoRA | Sustituir una llamada a Jev alojado |
| SemIf | 4,023 | MIT | Qwen3.5-4B congelado (sin fine-tune) | Reutilizar un modelo que ya alojas |
| NanoJev | 2,086 | MIT | Qwen3-0.6B + cabezas de decisión | Bucles de control en tiempo real |
| jevlike | 1,255 | MIT | Encoder de bytes o cualquier encoder HF congelado | Entrenar con tu propio conjunto de etiquetas |
1. Laya: el que todo el mundo marcó con estrella
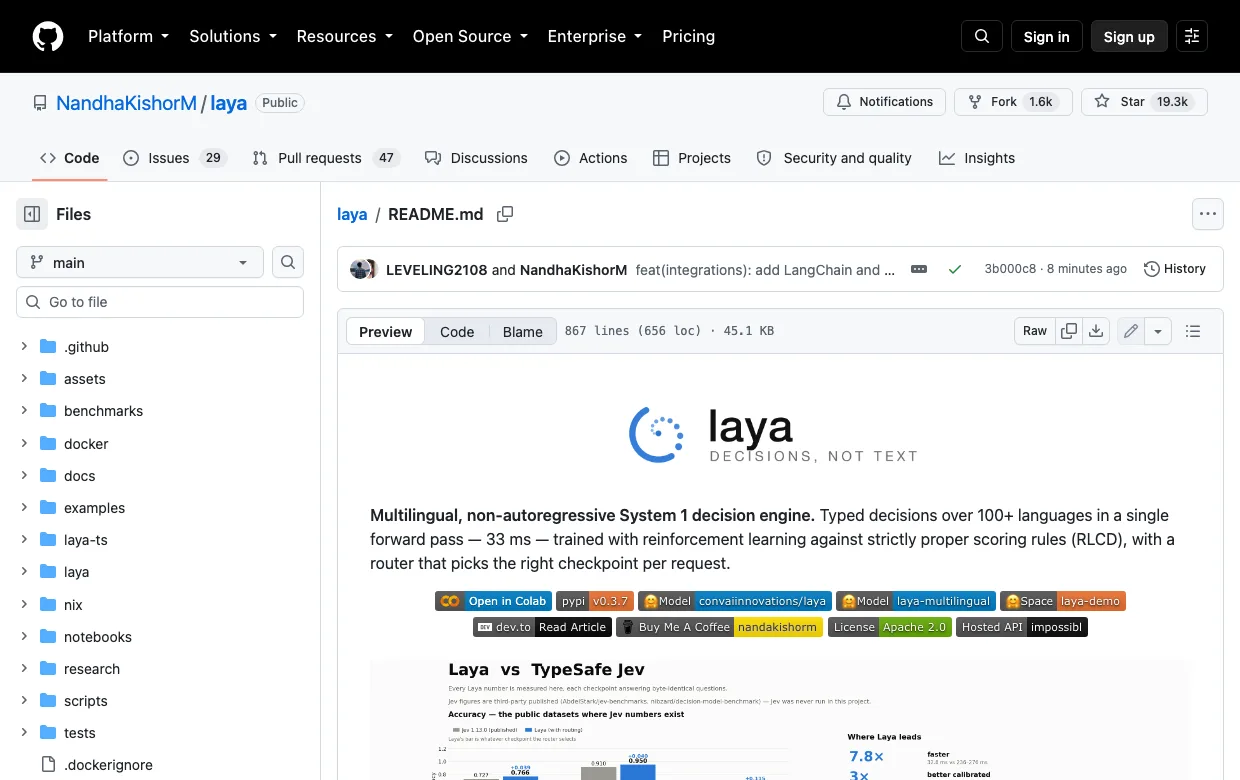
Laya es el buque insignia con mucha diferencia, y el único de los cinco que se instala con un simple pip install laya. Convai Innovations lo publicó el 18 de septiembre bajo Apache 2.0, y sus 421M parámetros se apoyan en un backbone ModernBERT-large con una cabeza de decisión encima. Un checkpoint multilingüe de 322M cubre más de 100 idiomas, y un Router elige entre los dos detectando el sistema de escritura en menos de un milisegundo.
La velocidad publicada es de 39.5 ms por pregunta en una Tesla T4, o 7.2 ms con diez en lote. Ejecuté el quickstart del README en un M3 Pro sin aceleración por GPU y medí 66 ms de mediana en 20 ejecuciones para las tres preguntas en una sola pasada:
import laya

agent = laya.load("convaiinnovations/laya")

state = {
    "subject": "Duplicate charge on invoice #4411",
    "body": "We were billed twice for March. Please refund the duplicate today or we will cancel our plan.",
}
questions = {
    "department": {"type": "choice", "instructions": "Which department should handle this request?",
                   "criteria": {"billing": "invoices, payments, refunds",
                                "technical": "bugs, outages, system errors",
                                "sales": "pricing, new contracts"}},
    "urgency": {"type": "score", "instructions": "How urgent is this request?",
                "criteria": ["not urgent", "soon", "critical deadline or blocking issue"]},
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
}

res = agent.predict(state, questions)["answers"]
print(res["department"]["choice"], res["department"]["confidence"])  # billing 0.827
print(res["urgency"]["score"], res["churn_risk"]["noul"])             # 1.49 0.741
La versión 0.3.7 redujo el tiempo de carga de los checkpoints unas diez veces, bajando laya.load() en esta máquina de 28 segundos a unos 4, y añadió laya-serve, un servidor FastAPI con el mismo protocolo POST /v1/systemone que Jev.
Ahora, la parte que esconde el número de estrellas. El README de Laya es inusualmente sincero: sus checkpoints base puntúan 0.362 y 0.342 en el benchmark de typed-decisions, frente a una línea base aleatoria de 0.318 y una línea base de clase mayoritaria de 0.461. El 0.766 del titular, que supera la cifra publicada de Jev, 0.727, viene de laya-typed-decisions, ajustado con el propio split de entrenamiento de ese benchmark. Trata Laya como una base rápida que especializas con tus propios datos, no como un reemplazo zero-shot. También flojea con conjuntos grandes de opciones: 0.425 frente al 0.870 de Jev en las 77 etiquetas de Banking77, porque las opciones comparten un presupuesto fijo de 192 a 256 tokens y a cada etiqueta le tocan tres o cuatro tokens.
2. Kev: el reemplazo directo con evaluaciones honestas
Kev es una familia de adaptadores LoRA de rango 16 más una pequeña pointer head sobre bases Qwen3.5 de 0.8B, 4B y 9B, creada por Jared Palmer. Sirve el propio contrato POST /v1/systemone de TypeSafe, así que el typesafe-sdk oficial funciona contra él con solo cambiar una base URL. Su hilo en Hacker News llegó a 438 puntos, y buena parte se fue en discutir si algo de esto supera a un BERT con fine-tuning. Levantarlo y consultarlo queda así, ejecutado aquí en el M3 Pro:
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-0.8b --port 8009curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
"state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
"model": "kev-latest",
"questions": {
"department": {"type": "choice", "instructions": "Which team should handle this?",
"criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
"shipping": "Delivery status, delays, lost packages",
"billing": "Charges, invoices, payment problems"}},
"escalate": {"type": "noul", "instructions": "Does this need urgent human attention?"},
"frustration":{"type": "score", "instructions": "How frustrated is the customer?",
"criteria": ["Calm", "Frustrated", "Very angry"]}
}}'Eso devolvió returns con 0.39 de probabilidad, shipping con 0.38 y billing con 0.24, el reparto correcto para un ticket que menciona las tres cosas. Kev añadió un backend MLX el 22 de septiembre, y en un Mac la diferencia es grande: la misma petición pasó de 213 ms en la antigua ruta PyTorch MPS a 77 ms con un estado nuevo y 47 ms con uno repetido, tras una primera llamada de 3.2 s.
Kev publica la evaluación más cuidadosa del grupo, incluidos los casos en los que pierde. Kev-9B saca 0.822 en fuentes nuevas reservadas frente al 0.857 de Jev, su tasa de errores con alta confianza es del 4.0% frente al 3.7%, y la proporción de decisiones que podrías automatizar con un presupuesto de error del 5% va de 0.45 a 0.57 frente al 0.70 de Jev. Las preguntas de conocimiento son la gran brecha - MMLU 0.74 frente a 0.90 - y eso es cosa del modelo base, no del adaptador.
3. SemIf: ningún modelo nuevo, solo leer los logits
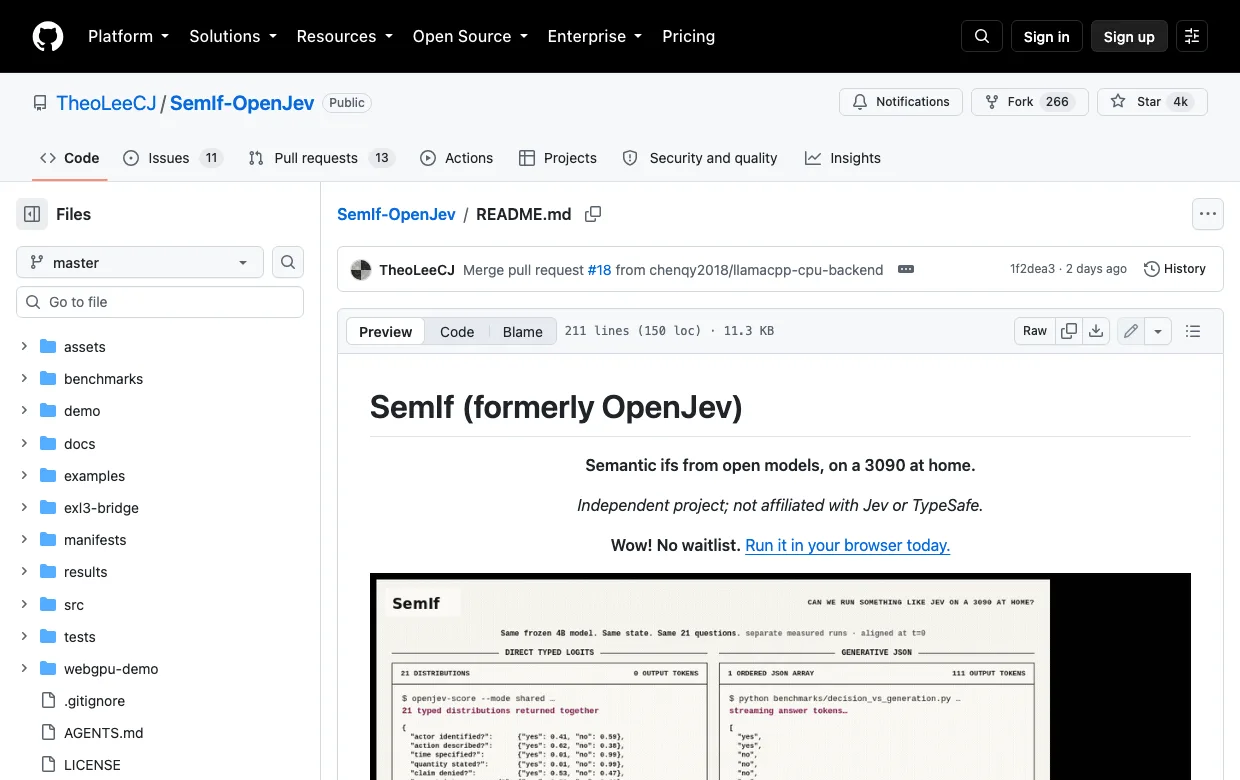
SemIf, que antes se llamaba OpenJev, no pretende haber reproducido el modelo de Jev. Reproduce el patrón: coges un modelo de pesos abiertos congelado que ya alojas, declaras tus opciones y lees sus probabilidades de los logits sin muestrear ni un solo token de respuesta.
Las pruebas a su favor se hacen en una sola RTX 3090 con un Qwen3.5-4B congelado, un estado y 21 criterios binarios. Logits tipados directos: 1.023 s, cero tokens de salida. Un array JSON autorregresivo con las mismas 21 respuestas: 5.332 s y 111 tokens de salida, 5.21x más tiempo. Reutilizar un mismo estado largo para muchos criterios sube el throughput de 2.33 decisiones por segundo a 20.03.
En calidad, la línea base de 4B llega a 0.845 de acuerdo modal con los resultados publicados por TypeSafe en un subconjunto alineado de 102 filas, frente al 0.883 de Jev, y un puente con Qwen3.8-27B cuantizado alcanza 0.958 de balanced accuracy en 144 decisiones redactadas a mano. Los fixtures, los hashes de los prompts y los tiempos en bruto están todos commiteados en el repo. Pide una GPU que aguante un modelo de 4B en BF16, pero hay un backend de CPU con llama.cpp, MLX y MPS para Apple Silicon, y una demo WebGPU en una pestaña del navegador.
4. NanoJev: 0.6B para bucles en tiempo real
NanoJev es el caso aparte, y el único proyecto de esta lista que claramente supera a Jev en algo. Es un backbone Qwen3-0.6B con cabezas de decisión entrenadas en cuatro entornos de juego, orientado al caso de bucle de control que hay detrás de la propia demo de Doom de TypeSafe.
En el conjunto de test reservado, un único checkpoint compartido consigue 128/128 éxitos en ViZDoom Basic frente a los 56/128 de Jev, y 27/128 en la tarea Predict Position, más dificil, frente a los 11/128 de Jev. Resuelve un laberinto de 50x50 en 225 intentos donde Jev necesita 2,738. Jev sigue ganando en el test del laberinto por 7/10 a 4/10, y empatan 8/8 en Snake.
Léelo por lo que es: un modelo entrenado con 18,760 preguntas de decisión de cuatro juegos y evaluado en esos mismos cuatro juegos, con pesos y dataset en Hugging Face bajo la etiqueta unified-games-v1. Es una prueba sólida de que un modelo de 0.6B entrenado a propósito puede dejar atrás a una API de decisión de frontera dentro de un bucle ajustado, y ninguna prueba de que vaya a clasificar tus tickets. El script de inferencia espera CUDA, así que hoy no hay forma de usarlo en Apple Silicon.
5. jevlike: entrena el tuyo desde cero
jevlike no es un modelo, es una receta. La arquitectura cabe en una frase: cada opción se convierte en un vector de consulta, esa consulta atiende sobre los tokens del contexto, un producto escalar compartido puntúa cada par opción-contexto y un softmax sobre las opciones da la distribución. El encoder por defecto aprende embeddings de bytes desde cero, o puedes acoplar la cabeza a cualquier encoder congelado de Hugging Face.
Tus datos son un objeto JSON por línea - {"context": "...", "options": [...], "label": 0} - y el bucle son cuatro comandos en CPU, MPS o CUDA. La evaluación imprime la precisión top-1, el error de calibración y un control con contexto barajado que empareja cada menú con el contexto equivocado, el tipo de línea base que la mayoría de proyectos se salta.
Es la opción adecuada cuando las opciones son tuyas: categorías internas de enrutado, una taxonomía de productos, un conjunto de acciones de un playbook. Es la opción equivocada si necesitas algo funcionando esta misma tarde, y el autor no lo esconde: el checkpoint de ajedrez incluido pierde 48 de 50 partidas contra Stockfish en nivel 0, y el encoder de bytes por defecto trunca el contexto a 192 bytes.
Qué dice el benchmark independiente
Cada proyecto de arriba se compara con Jev en un conjunto de pruebas elegido por él mismo, y todos ganan en el suyo. La cifra útil viene de otro sitio. El benchmark de clasificadores de jabr ejecuta 49 tareas y 869 casos de cumplimiento normativo, triaje, legal, DevOps, lingüística y seguridad:
| Sistema | Macro accuracy v2 (49 tareas) |
|---|---|
| TypeSafe Jev (alojado) | 0.966 |
| Von (395M, abierto) | 0.704 |
| GLiNER2 (~300M, abierto) | 0.698 |
| Laya (421M, abierto) | 0.583 |
Es una brecha de 26 puntos en tareas fuera de dominio, con un modo de fallo distinto documentado para cada uno: Von sufre colapso de modo en dominios desconocidos, GLiNER2 se dispara de más con las palabras clave y Laya comprime las escalas de valoración. Fíjate en que Von (546 estrellas, Apache-2.0, ModernBERT-Large) lidera el campo abierto pese a estar muy por debajo de Laya en estrellas, un recordatorio de que las estrellas miden atencion, no precisión. Dentro del dominio, tras un fine-tune con tus propias etiquetas, los modelos abiertos son competitivos. Fuera del dominio y en zero-shot, todavía están lejos.
Probar un servidor de decisiones local desde fuera de tu máquina
Kev, SemIf, Von y ahora Laya exponen todos un endpoint HTTP ligado a tu propia máquina, lo cual está bien hasta que algo de fuera tiene que llamarlo: una app de staging, un webhook que alimenta al clasificador, un compañero revisando el enrutado o un router que manda las decisiones pequeñas al modelo barato. Con Kev escuchando en el puerto 8009, un solo comando le da una URL HTTPS pública usando Pinggy:
ssh -p 443 -R0:localhost:8009 free.pinggy.io
Esto importa durante una migración, porque la forma honesta de elegir entre estos modelos es pasarles tráfico real en sombra a los dos: apunta una copia de los webhooks de producción al túnel, registra lo que habría decidido el modelo abierto y compáralo con la respuesta real de Jev. Una advertencia - los dos servidores están abiertos por defecto, así que configura KEV_API_KEY o LAYA_API_KEY para exigir un bearer token antes de exponer cualquiera de ellos.
Cuál elegir
Para el camino más corto de una llamada a Jev alojado a una autoalojada, usa Kev: la API coincide a nivel de protocolo y tu código no cambia. Si ya ejecutas un modelo de pesos abiertos, usa SemIf y lee los logits de lo que ya tienes. Si quieres algo pequeño, que vaya bien en CPU, con cobertura multilingüe, y estás dispuesto a hacer fine-tuning, usa Laya. Si tus decisiones viven dentro de un bucle de control ajustado, NanoJev es el único proyecto de esta lista con pruebas a esa latencia. Si tu conjunto de etiquetas es lo bastante raro como para que ningún checkpoint preentrenado ayude, jevlike te entrena uno en un portátil.
Hay otros tres que merece la pena guardar en marcadores: OpenJev ejecuta DiffusionGemma 26B-A4B y es el único que responde preguntas sobre imágenes, openjev-sglang sirve Qwen3.6-35B-A3B en SGLang para hardware de clase B200, y Von lidera el benchmark independiente.
Conclusión
El ecosistema abierto reprodujo la interfaz de Jev en más o menos un día y lleva la semana desde entonces intentando reproducir su precisión. En latencia, precio y control ya gana sin discusión: un encoder de 421M en tu propia CPU no cuesta nada por llamada y respondió en 66 ms en el portátil donde lo probé. En calidad zero-shot fuera de dominio no gana, y 0.966 frente a 0.704 es la cifra que hay que recordar cuando alguien llame a uno de estos un reemplazo directo.
Así que elige el que tenga una historia de despliegue parecida a la tuya, hazle fine-tuning con unos cientos de tus propios ejemplos etiquetados, reajusta la temperatura de confianza y mídelo contra lo que ejecutas hoy. Estos proyectos apenas tienen una semana y se mueven tan rápido que una cifra se queda vieja en un día, así que trata cada número publicado, incluidos los del fabricante, como una hipótesis y no como un resultado - la misma precaución que vale para autoalojar modelos en general.