Los mejores modelos de texto a voz de código abierto para self-hosting en 2026
Actualizado el 29 oct 2026 · 39 min de lectura
El texto a voz se ha convertido, sin hacer mucho ruido, en una de esas cosas que todo proyecto acaba necesitando: narración para un vídeo, una voz para un agente, una capa de accesibilidad, notificaciones que no necesitan pantalla. Durante casi toda la última década, la respuesta práctica era mandar tu texto a la API de alguien y pagar por carácter, porque los modelos que podías ejecutar tú mismo sonaban como un GPS.
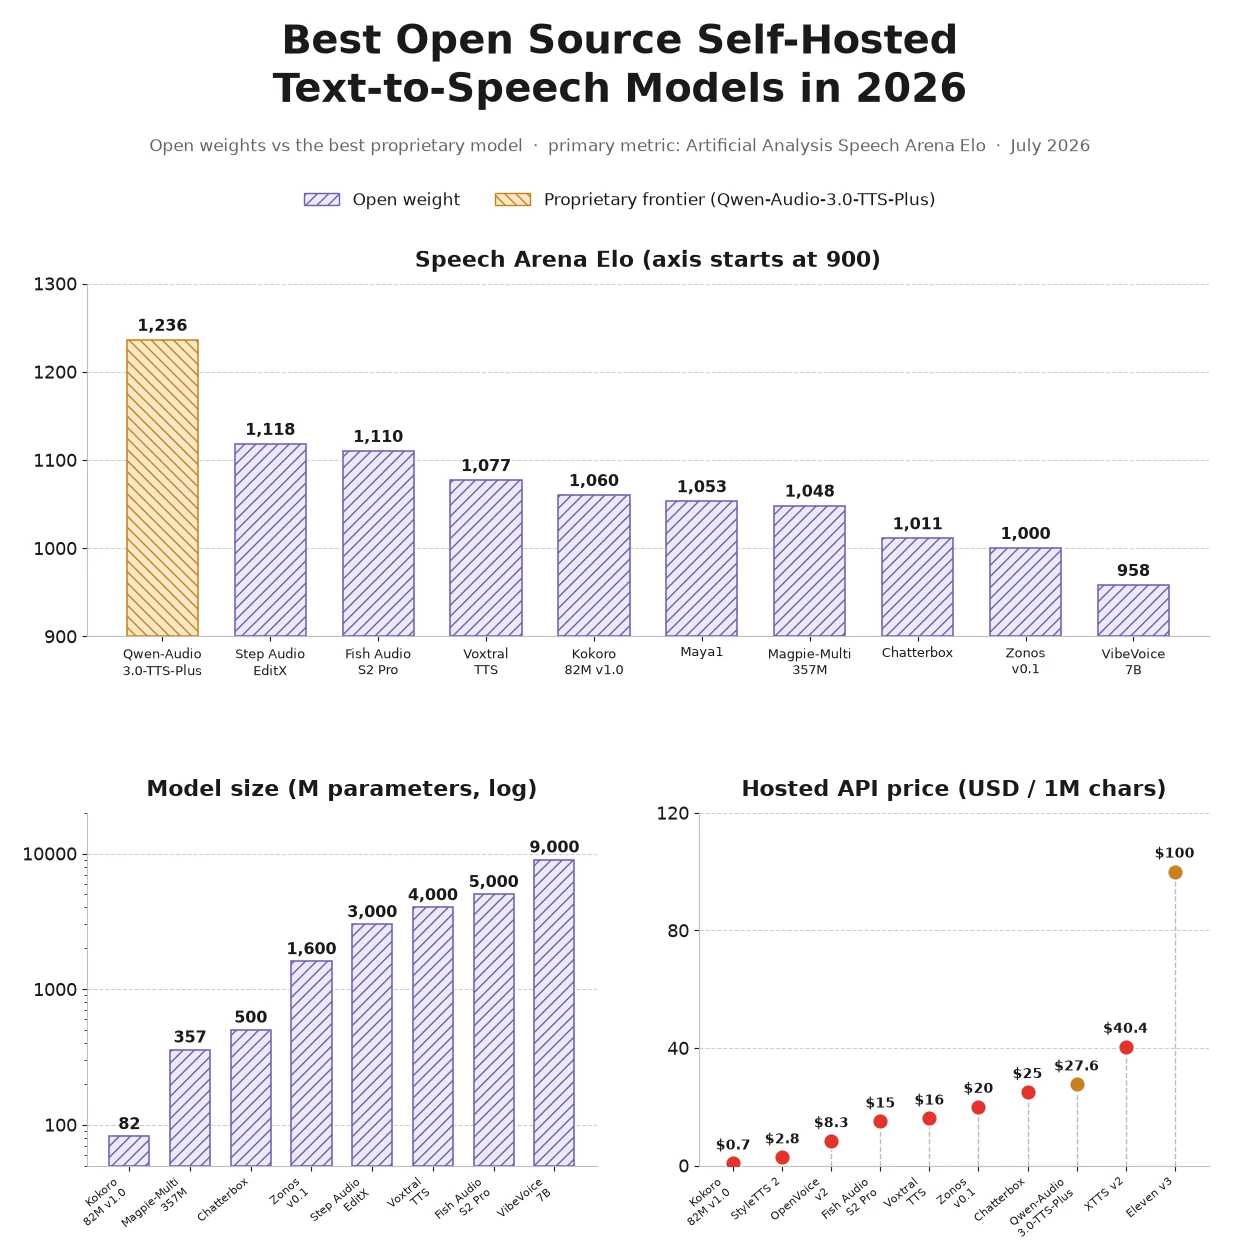
Eso ya no es así, y desde la semana pasada ni siquiera hay discusión. Breeze TTS 2, publicado el 25 de agosto de 2026, consigue 1,215 Elo en el Speech Arena de Artificial Analysis, por encima de ElevenLabs Eleven v3 (1,177), el modelo por el que ElevenLabs cobra $100 por millón de caracteres. Es el primer modelo de pesos abiertos que supera al buque insignia de ElevenLabs en esa tabla, seis semanas después de que los mejores pesos abiertos estuvieran 59 puntos por debajo, y puedes ejecutarlo en una tarjeta de 12GB.
El otro extremo del rango es igual de raro: Kokoro tiene 82 millones de parámetros, funciona en la CPU de un portátil, es Apache 2.0, y aun así quienes escuchan a ciegas lo prefieren antes que VibeVoice, el modelo de Microsoft con 9 mil millones de parámetros. Todos los modelos de esta lista funcionan con una sola GPU, y varios corren en hardware que ya tienes.
La frontera sigue por delante, solo que no tan lejos. Sonic 3.6, el modelo propietario de Cartesia, encabeza la tabla general con 1,283 frente a 1,215 del mejor modelo de pesos abiertos: una diferencia de 68 puntos, cuando en julio era de 118. Y en lo económico no hay color: el modelo abierto con mejor relación calidad-precio cuesta unos $0.70 por millón de caracteres en hosting, frente a $100 de ElevenLabs v3, y nada más que la electricidad si lo ejecutas tú.
Esta guía repasa los modelos TTS de pesos abiertos que merece la pena alojar tú mismo en agosto de 2026, en qué destaca cada uno, las trampas de licencia (que empeoraron este verano) y las herramientas para desplegarlos.
Resumen
Los mejores modelos TTS de pesos abiertos (pruebas de escucha a ciegas, agosto de 2026):
- Breeze TTS 2 - 1,215 - supera a ElevenLabs v3; clonación, diseño y dirección de voz; no comercial - Hugging Face
- Fish Audio S2 Pro - 1,125 - prosodia con
[tag]en línea, más de 80 idiomas, no comercial - fish.audio/s2 - Step Audio EditX - 1,102 - edición de emociones, Apache 2.0, la mejor opción que puedes usar en un producto - Página del proyecto
- Voxtral TTS - 1,082 - clonación con 3 segundos, el mejor de pesos abiertos en la tabla de voz controlada - Mistral
- Magpie-Multilingual 357M - 1,066 - 9 idiomas, seguro para uso comercial - NVIDIA
- Kokoro 82M v1.0 - 1,060 - funciona en CPU, Apache 2.0, sin clonación - GitHub
- Maya1 - 1,045 - diseña una voz a partir de texto, Apache 2.0 - mayaresearch.ai
- Higgs Audio V3 TTS - 1,042 - más de 100 idiomas con WER publicado, no comercial - Hugging Face
- Chatterbox - 1,020 - MIT, 23 idiomas, control de emociones - resemble.ai
- Zonos-v0.1 - 1,000 - Apache 2.0, 44kHz, 6GB de VRAM - Zyphra
Tres que el Speech Arena no ha puntuado, dos de ellos Apache 2.0:
- Qwen3-TTS - Apache 2.0, 0.6B/1.7B, 10 idiomas, más de 5M de descargas - GitHub
- VoxCPM2 - Apache 2.0, 2B, 30 idiomas, 48kHz, funciona en CPU - GitHub
- GLM-TTS - pesos MIT, chino/inglés, 0.89 de CER - GitHub
Fíjate en la licencia, no en el marketing. Los dos primeros de la tabla son no comerciales aunque se presenten como open source, y el #8 también. Step Audio EditX (#3) es el modelo mejor clasificado que puedes usar en un producto; Qwen3-TTS y VoxCPM2 son las opciones Apache 2.0 más sólidas en general.
No existe ningún modelo TTS de DeepSeek. DeepSeek V4 es solo de texto. Qwen3-TTS y GLM-TTS son los modelos TTS abiertos de laboratorios chinos que existen de verdad.
Las mejores herramientas para self-hosting:
- LocalAI - la mayor cobertura de modelos, compatible con OpenAI
- vLLM-Omni - servicio en GPU para producción con los TTS de nueva generación
- llama.cpp-omni - VoxCPM2 en GGUF sobre CPU, Metal, CUDA o Vulkan, sin PyTorch
- Kokoro-FastAPI - el camino más rápido hacia un endpoint funcionando
Dónde están hoy los modelos de pesos abiertos
El ranking sale del Speech Arena de Artificial Analysis, donde quien escucha oye dos clips del mismo texto sin saber qué modelo generó cada uno y elige el mejor. Es la señal más útil en TTS, porque mide si el resultado le suena bien a una persona, y no una métrica contra la que un fabricante puede entrenar.
Breeze TTS 2 rompió el patrón. Durante el último año, la parte alta de la tabla de pesos abiertos era una melé dentro de una franja de 125 puntos; Breeze superó al #2 por 90 Elo en un solo lanzamiento y quedó sexto de 100 modelos en la clasificación general, por delante de ElevenLabs Eleven v3 y del StepAudio 2.5 TTS cerrado de la propia StepFun. Detrás, siete modelos, de Fish S2 Pro hasta Higgs Audio V3, caben en 85 puntos entre sí, aunque van de 82M a 4B parámetros y no se ponen de acuerdo en absoluto sobre para qué sirve un modelo TTS.
Esa dispersión es el verdadero titular. El tamaño casi ha dejado de predecir la calidad. Kokoro está sexto con 82M, por delante de modelos cincuenta veces más grandes, y Magpie de NVIDIA hace nueve idiomas con 357M y lo supera. La carrera armamentística de los billones de parámetros que define a los LLM de pesos abiertos simplemente no está ocurriendo aquí.
Dos tablas, dos respuestas distintas
El arena principal, Provider Voices, deja que cada modelo compita con sus propias voces integradas, así que estás votando el modelo y las voces que eligieron sus creadores. El Controlled Voice Arena, añadido en julio de 2026, da a todos los modelos las mismas 8 voces clonadas. Solo incluye modelos capaces de clonar, así que Kokoro, Maya1 y Magpie no aparecen por definición. El cambio de posiciones es considerable:
| Modelo | Provider Voices | Controlled Voice |
|---|---|---|
| Breeze TTS 2 | 1,215 (1.º) | 1,002 (2.º) |
| Fish Audio S2 Pro | 1,125 (2.º) | 1,000 (3.º) |
| Voxtral TTS | 1,082 (4.º) | 1,010 (1.º) |
| Higgs Audio V3 TTS | 1,042 (8.º) | 958 (4.º) |
| Chatterbox | 1,020 (9.º) | 927 (5.º) |
La ventaja de 90 puntos de Breeze se convierte en un empate a tres con Voxtral y Fish cuando todos clonan las mismas voces, y eso dice algo práctico: las voces propias de BreezeBlue son excelentes y su clonación es del montón. Elige la tabla según tu caso de uso. ¿Vas a usar voces de serie? Provider Voices. ¿Vas a clonar a tu propio narrador o a un cliente? Controlled Voice, donde gana Voxtral TTS. Por cierto, los modelos cerrados aguantan mejor el control: Sonic 3.6 lo lidera con 1,120, una ventaja de 110 puntos sobre los pesos abiertos, frente a los 68 de la tabla de proveedores.
Clasificación de pesos abiertos (agosto de 2026)
| Modelo | Creador | Elo | Licencia |
|---|---|---|---|
| Cartesia Sonic 3.6 (propietario, como referencia) | Cartesia | 1,283 | Cerrado |
| Breeze TTS 2 | BreezeBlue | 1,215 | Investigación (no comercial) |
| ElevenLabs Eleven v3 (propietario, como referencia) | ElevenLabs | 1,177 | Cerrado |
| Fish Audio S2 Pro | Fish Audio | 1,125 | Investigación (no comercial) |
| Step Audio EditX | StepFun | 1,102 | Apache 2.0 |
| Voxtral TTS | Mistral | 1,082 | CC BY-NC 4.0 |
| Magpie-Multilingual 357M (v2602) | NVIDIA | 1,066 | NVIDIA Open Model |
| Kokoro 82M v1.0 | hexgrad | 1,060 | Apache 2.0 |
| Maya1 | Maya Research | 1,045 | Apache 2.0 |
| Higgs Audio V3 TTS | Boson AI | 1,042 | Investigación (no comercial) |
| Chatterbox | Resemble AI | 1,020 | MIT |
| Magpie-Multilingual 357M (enero de 2026) | NVIDIA | 1,004 | NVIDIA Open Model |
| Zonos-v0.1 | Zyphra | 1,000 | Apache 2.0 |
| VibeVoice 7B | Microsoft | 969 | MIT (retirado) |
| OpenVoice v2 | MyShell | 954 | MIT |
| XTTS v2 | Coqui | 920 | CPML (no comercial) |
| StyleTTS 2 | Li et al. | 892 | MIT + condiciones |
| MetaVoice v1 | MetaVoice | 844 | Apache 2.0 |
Se incluyen dos modelos propietarios como punto de referencia: Cartesia Sonic 3.6, líder de la clasificación general, y ElevenLabs Eleven v3, al que Breeze TTS 2 ya supera. Para ver las puntuaciones actuales y la lista completa de 100 modelos, consulta directamente la clasificación del Speech Arena.
Los mejores modelos TTS de código abierto
1. Breeze TTS 2 (BreezeBlue) - el nuevo líder, y supera a ElevenLabs v3
Breeze TTS 2 se anunció el 7 de agosto de 2026 y los pesos se publicaron el 25 de agosto, reescribiendo la parte alta de esta lista dos días antes de que la actualizáramos: 1,215 Elo, 90 puntos por encima de Fish Audio S2 Pro, sexto de 100 modelos contando abiertos y cerrados, y el primer modelo de pesos abiertos que supera a ElevenLabs Eleven v3 (1,177), el buque insignia de $100 por millón de caracteres.
Es un transformer de 3B con tres formas distintas de conseguir una voz, más de lo que ofrece cualquier otro modelo de esta lista: clonación a partir de audio de referencia, Voice Design, que construye un locutor a partir de una descripción escrita sin ninguna referencia, y Voice Direction, que clona una voz y controla a la vez su tono, emoción y ritmo. Esto último es lo interesante, porque la mayoría de modelos te obligan a elegir entre copiar a un locutor y dirigir una interpretación. Los eventos vocales van en línea como (laugh), (cough), (sigh) en inglés o [笑], [咳嗽], [叹气] en chino.
Es barato de ejecutar para el nivel que tiene: unos 7.7GiB de VRAM en inferencia eager, así que una tarjeta de 12GB es el mínimo indicado, y el modo rápido pide ~14.4GiB y una tarjeta de 24GB. En una H100 con el modo rápido ya calentado, BreezeBlue indica menos de 40ms hasta el primer audio y RTF 0.32 (~3.1x tiempo real).
Tres pegas reales.
La licencia es no comercial. El código de inferencia es Apache 2.0; los pesos están bajo la BreezeBlue Research and Non-Commercial License, y el uso comercial requiere autorización por escrito de RESONIA, INC.
Lo de los idiomas no se sostiene. breezeblue.ai anuncia “50 idiomas, con control de acento”. La ficha del modelo en Hugging Face etiqueta exactamente dos, en y zh, y documenta etiquetas de eventos vocales solo para esos dos. Da por no probado cualquier idioma que no sea inglés o mandarín.
La ventaja de 90 puntos se debe en parte a sus voces, no a su modelo. En el Controlled Voice Arena, donde todos los modelos clonan las mismas 8 voces, Breeze consigue 1,002 frente a los 1,010 de Voxtral TTS y los 1,000 de Fish S2 Pro: un empate a tres. Las voces integradas de BreezeBlue son excelentes; su clonación es normal y corriente.
Además, tiene dos días de vida y todavía no hay soporte en vLLM-Omni, así que para servirlo tienes la CLI de PyTorch, la API de streaming o la imagen de Docker.
Especificaciones clave
- Arquitectura: transformer de 3B, streaming, escala de guía CFG
- Licencia: código Apache 2.0, pesos bajo la BreezeBlue Research and Non-Commercial License
- Lanzamiento: anunciado el 7 de agosto de 2026; pesos el 25 de agosto de 2026
- Idiomas: inglés y mandarín documentados (el fabricante dice 50)
- Elo en Speech Arena: 1,215 provider-voice / 1,002 controlled-voice
- Self-hosting: mínimo 12GB de VRAM (~7.7GiB en eager), 24GB para el modo rápido; CLI de PyTorch o Docker
- Limitaciones: pesos no comerciales, todavía sin soporte en vLLM-Omni, un ecosistema de pocos días
2. Fish Audio S2 Pro - etiquetas de prosodia en línea, licencia no comercial y la mejor clonación
Fish Audio S2 Pro (marzo de 2026) ocupó el puesto #1 durante casi todo el verano y ahora es segundo con 1,125 Elo, 15 puntos más que en julio a medida que se acumulaban los votos. Tiene la superficie de control más agradable de toda la lista. Escribes la prosodia directamente en el texto como etiquetas libres:
[clears throat] Hey chat, how do I solve merge conflicts again?
[whisper in small voice] I definitely knew the answer yesterday. [exhale]
Reconoce más de 15,000 etiquetas, y aceptan descripciones en lenguaje natural en lugar de un enum fijo, así que tanto [pitch up] como [flirty] funcionan, con mucha menos fricción que pelearte con vectores de condicionamiento.
En cuanto a arquitectura, es un diseño Dual-AR: un “Slow AR” de 4B construido sobre Qwen3-4B predice tokens semánticos, y un “Fast AR” de 400M completa la acústica a lo largo de 10 codebooks RVQ. Fish indica un 0.54% de WER en el conjunto de prueba chino de Seed-TTS y una tasa de victorias del 81.88% en EmergentTTS-Eval, con más de 80 idiomas organizados por niveles (japonés, inglés y chino son de nivel 1). El servicio se basa en SGLang: RTF 0.195 y ~100ms hasta el primer audio en una sola H200.
La pega es la licencia. A pesar del titular “ahora open source” de la página de producto, los pesos están bajo la Fish Audio Research License: gratis para investigación, y el uso comercial requiere un acuerdo aparte. Cuidado con una confusión: el paper de arXiv es CC BY 4.0, pero esa es la licencia del paper, no la de los pesos. Fish no publica un mínimo de VRAM.
Especificaciones clave
- Arquitectura: Dual-AR - Slow AR de 4B (basado en Qwen3-4B) + Fast AR de 400M, 10 codebooks RVQ
- Licencia: Fish Audio Research License (no comercial)
- Lanzamiento: 9 de marzo de 2026
- Idiomas: más de 80 (por niveles)
- Elo en Speech Arena: 1,125 provider-voice / 1,000 controlled-voice
- Benchmarks del fabricante: 0.54% de WER (Seed-TTS test-zh), 81.88% de victorias en EmergentTTS-Eval
- Self-hosting: SGLang o vLLM-Omni; RTF 0.195 en una sola H200; sin mínimo de VRAM publicado
3. Step Audio EditX (StepFun) - la mejor opción que de verdad puedes usar en un producto
Step Audio EditX era el #1 en nuestra edición de julio con 1,118 Elo. Ahora es tercero con 1,102: no ha empeorado, es que la tabla se ha llenado y su puntuación bajó 16 puntos a medida que llegaban más votos. Lo que importa más es que es el modelo de pesos abiertos mejor clasificado que puedes meter en un producto comercial, porque los dos que tiene por encima son no comerciales y él es Apache 2.0. StepFun publicó los pesos en noviembre de 2025 y mejoró la parte paralingüística en enero de 2026.
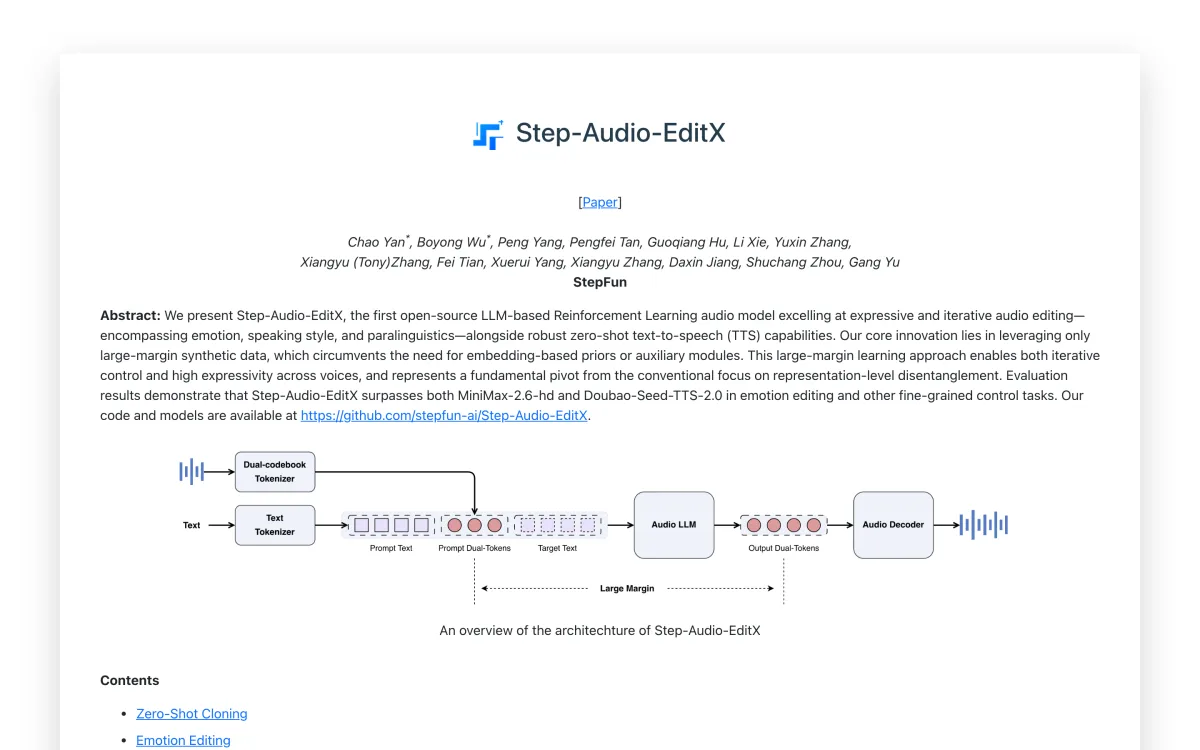
Lo interesante es que en realidad no es un modelo TTS con la edición añadida a posteriori: es un modelo de edición de audio que también hace TTS. Un tokenizador de doble codebook convierte la voz en tokens discretos, un LLM de audio de 3B los manipula y un decodificador de flow matching los vuelve a convertir en forma de onda. Como las ediciones ocurren en el espacio de tokens y no mediante DSP sobre la forma de onda, puedes refinar una toma de forma iterativa: generar, ajustar la emoción, volver a ajustarla.
En la práctica, eso te da más de 14 emociones, más de 30 estilos de habla, más de 20 etiquetas paralingüísticas (respiración, risa, suspiros), clonación zero-shot y utilidades como eliminación de ruido y recorte de silencios. StepFun indica un 81.6% de precisión emocional en chino tras tres iteraciones de refinado.
Las contrapartidas son reales. Está pensado para clips de menos de 30 segundos por inferencia, así que la narración larga implica trocear el texto tú mismo, y la cobertura de idiomas es limitada (mandarín, inglés, sichuanés, cantonés, japonés, coreano). Además, el proyecto se ha quedado en silencio: el último commit fue en abril de 2026 y la atención de StepFun se ha ido a StepAudio 2.5 TTS, que solo está disponible por API (1,208 Elo, cerrado). No es motivo para evitarlo, pero no esperes una v2.
Especificaciones clave
- Arquitectura: tokenizador de doble codebook, LLM de audio de 3B, decodificador de flow matching
- Licencia: Apache 2.0
- Lanzamiento: noviembre de 2025, actualizado en enero de 2026
- Idiomas: mandarín, inglés, sichuanés, cantonés, japonés, coreano
- Elo en Speech Arena: 1,102 (los pesos abiertos con licencia comercial mejor clasificados de esta guía)
- Self-hosting: mínimo 12GB de VRAM (probado en una L40S), compatible con vLLM
4. Voxtral TTS (Mistral) - la mejor clonación de voz con 3 segundos
Voxtral TTS (23 de marzo de 2026) consigue 1,082 Elo y es el modelo más sencillo de esta lista a la hora de ponerlo en marcha: una sola GPU con 16GB de VRAM, servido con vLLM Omni.
Y también es, sin hacer ruido, el mejor clonador de pesos abiertos que existe. En el Controlled Voice Arena lidera todos los pesos abiertos con 1,010, por delante de Breeze TTS 2 (1,002) y Fish S2 Pro (1,000). Si tu trabajo es “haz que esta voz concreta diga este texto”, esa es la tabla que tienes que mirar, y Voxtral la gana.
Son tres piezas que suman ~4B parámetros: un decodificador de 3.4B basado en Ministral 3B predice tokens semánticos a partir del texto y un prompt de voz, un transformer de flow matching de 390M se encarga de la acústica y un códec neuronal de 300M produce la forma de onda a 24kHz.
Su truco estrella es clonar a partir de unos tres segundos de audio de referencia sin necesidad de transcripción, deduciendo la prosodia y la emoción del prompt de voz en lugar de necesitar etiquetas. Mistral indica una tasa de preferencia humana del 68.4% frente a ElevenLabs Flash v2.5 en clonación zero-shot a ciegas, y por una vez documenta bien el rendimiento: en una H200, RTF 0.103 con una petición concurrente (~9.7x tiempo real), que baja a 0.302 con 32 concurrentes.
Dos pegas. Es CC BY-NC 4.0, o sea, no comercial. Y Mistral no publica cifras de WER ni de similitud de locutor, con el argumento de que priorizaron la evaluación humana de naturalidad: defendible, pero no puedes ponerlo al lado de las cifras de Fish.
Especificaciones clave
- Arquitectura: decodificador de 3.4B (basado en Ministral 3B) + modelo acústico de flow matching de 390M + códec de 300M
- Licencia: CC BY-NC 4.0 (no comercial)
- Lanzamiento: 23 de marzo de 2026
- Idiomas: 9 - inglés, francés, alemán, español, neerlandés, portugués, italiano, hindi, árabe
- Elo en Speech Arena: 1,082 provider-voice / 1,010 controlled-voice (el mejor de pesos abiertos)
- Self-hosting: una sola GPU, 16GB+ de VRAM, vLLM Omni 0.18.0+; RTF 0.103 en una H200
5. NVIDIA Magpie-Multilingual 357M - la opción multilingüe segura para uso comercial
Magpie-TTS Multilingual tiene 357M parámetros, cubre 9 idiomas y se distribuye bajo la NVIDIA Open Model License, que permite el uso comercial. Pequeño, multilingüe y apto para uso comercial es una combinación más rara de lo que debería.
Es un transformer encoder-decoder que predice 8 codebooks de tokens NanoCodec a 22kHz, entrenado con 38k horas, con priors de atención basados en CTC para forzar un alineamiento monótono: el arreglo habitual para los saltos y repeticiones a los que tiende el TTS autorregresivo.
El checkpoint más reciente (v2602, que añadió hindi y japonés) consigue ahora 1,066, 62 Elo más que los 1,004 del checkpoint de enero. Es un buen recordatorio de que estos modelos mejoran de forma notable entre versiones menores, y bastó para colocar a Magpie por encima de Kokoro desde nuestra edición de julio. Con el checkpoint de enero, NVIDIA indica 0.34% de CER y 0.835 de similitud de locutor en LibriTTS test-clean, cifras que empeoran en los conjuntos CML no ingleses (francés: 2.70% de CER, 0.703 SV-SSIM).
Dos omisiones deliberadas antes de que lo elijas. Se eliminó la clonación zero-shot: la ficha del modelo lo dice sin rodeos, “hemos eliminado las capacidades zero-shot”, así que tienes 5 locutores fijos y nada más. Y la voz emocional está reservada al NIM empresarial. Esa es la idea, supongo: está pensado para agentes de voz y embajadores de marca, donde quieres una voz coherente y ninguna posibilidad de suplantar a nadie. Si quieres clonación de NVIDIA, es otro modelo, Magpie TTS Zeroshot, con 926 en el Controlled Voice Arena.
Ten en cuenta también el límite de 20 segundos por inferencia en modo estándar; el modo de formato largo usa una ventana deslizante y solo funciona en inglés.
Especificaciones clave
- Arquitectura: transformer encoder-decoder, NanoCodec de 8 codebooks a 22kHz, 357M parámetros
- Licencia: NVIDIA Open Model License (se permite el uso comercial)
- Lanzamiento: enero de 2026 (v2512), 3 de marzo de 2026 (v2602, añade hindi + japonés)
- Idiomas: 9 - inglés, español, alemán, francés, italiano, vietnamita, mandarín, hindi, japonés
- Elo en Speech Arena: 1,066 (checkpoint v2602) / 1,004 (enero de 2026)
- Self-hosting: NeMo Framework 25.11; A10/A30/A100/H100; sin cifra de VRAM publicada
- Limitaciones: sin clonación de voz, sin control de emociones en los pesos abiertos, 20s por inferencia
6. Kokoro 82M v1.0 - 82 millones de parámetros, y sigue entre los seis primeros
Kokoro no tendría por qué estar aquí. Tiene 82M parámetros, más o menos 1/60 del tamaño de Fish Audio S2 Pro, y consigue 1,060 Elo, por delante de Maya1 (3B), Higgs Audio V3 (4B), Chatterbox y VibeVoice 7B, con una puntuación que no se ha movido ni un punto desde julio. Usa una arquitectura StyleTTS 2 con un vocoder ISTFTNet, sin difusión, entrenada con “unos cientos de horas” de audio sintético y con licencias permisivas. Funciona con menos de 2GB de VRAM, o solo con CPU en unos 4GB de RAM mediante ONNX, y es Apache 2.0. Además es, con una ventaja que nadie está recortando, el modelo TTS abierto más usado del mundo: 12 millones de descargas en Hugging Face en un solo checkpoint, más del doble que toda la familia Qwen3-TTS.
La contrapartida es tajante: ni clonación de voz ni control de emociones. Tienes 54 voces predefinidas en 8 idiomas, y ese es todo el menú. Si tu caso de uso es “lee este texto con una voz decente, barato y a escala” (audiolibros, notificaciones, accesibilidad, el narrador de una app), Kokoro es la respuesta correcta y nada se le acerca en coste. Si necesitas la voz de una persona concreta o una lectura con una emoción concreta, no puede hacerlo a ningún precio.
Dos notas prácticas. Las cifras de velocidad que se citan a menudo (~0.03 RTF en una A100, ~2.4x tiempo real en CPU) vienen de benchmarks de terceros, no de hexgrad: no hay cifras oficiales. Y el repositorio de referencia está congelado desde agosto de 2025, con el ecosistema trasladado a kokoro-onnx y Kokoro-FastAPI. El modelo funciona; simplemente el repo dejó de necesitar cambios. Ten en cuenta tambien que Kokoro no tiene web oficial: la ficha del modelo se desvincula de cualquier sitio con “kokoro” en el dominio raíz, así que GitHub y Hugging Face son sus únicas casas canónicas.
Especificaciones clave
- Arquitectura: StyleTTS 2 + vocoder ISTFTNet, solo decodificador, 82M parámetros
- Licencia: Apache 2.0
- Lanzamiento: 27 de enero de 2025
- Idiomas: 8 idiomas, 54 voces predefinidas
- Elo en Speech Arena: 1,060
- Self-hosting: menos de 2GB de VRAM, o solo CPU mediante ONNX; compatible con MPS en Apple Silicon
- Limitaciones: sin clonación de voz, sin control de emociones
Tenemos una guía completa para ejecutarlo en hardware gratuito: Self-hosting de una IA de texto a voz gratis en Google Colab.
7. Maya1 - describe con palabras la voz que quieres
Maya1 (noviembre de 2025, Apache 2.0) consigue 1,045 Elo y plantea el control de la voz de una forma realmente distinta. En lugar de clonar a partir de un clip de referencia, describes la voz que quieres:
<description="40-year-old male, warm, low pitch, conversational">
Eso es diseño de voz mediante prompt, y esquiva el problema de consentimiento que crea la clonación con audio de referencia: no estás copiando a nadie, estás especificando un locutor sintético. Es un decodificador de 3B estilo Llama que alimenta un códec neuronal SNAC a 24kHz mono, con más de 20 etiquetas de emoción en línea y streaming con una latencia que, según dicen, baja de 100ms en vLLM. Pide 16GB+ de VRAM, y hay cuantizaciones GGUF de la comunidad si quieres algo más pequeño.
Dos cosas que debes saber. Es solo en inglés, y el soporte multilingüe figura como trabajo futuro. Y Breeze TTS 2, Qwen3-TTS VoiceDesign y VoxCPM2 ya hacen diseño de voz por prompt, así que el rasgo distintivo de Maya1 ha dejado de ser único: la ventaja que le queda es la licencia Apache 2.0. Maya Research sigue presumiendo de ser el #2 entre los modelos de voz de pesos abiertos; eso viene de su lanzamiento en noviembre de 2025, y ahora está séptimo.
Ten en cuenta que mayaresearch.ai es la única página oficial: maya1.org y otros resultados parecidos que salen arriba en los buscadores son sitios SEO sin relación con el proyecto.
Especificaciones clave
- Arquitectura: decodificador de 3B estilo Llama + códec neuronal SNAC, 24kHz
- Licencia: Apache 2.0
- Lanzamiento: noviembre de 2025
- Idiomas: solo inglés (varios acentos)
- Elo en Speech Arena: 1,045
- Self-hosting: una sola GPU, 16GB+ de VRAM, vLLM; latencia de streaming declarada por debajo de 100ms
8. Higgs Audio V3 TTS (Boson AI) - más de 100 idiomas con las tasas de error publicadas
Higgs Audio V3 TTS (4 de junio de 2026) consigue 1,042 Elo con 219,000 descargas en Hugging Face, una tracción respetable para un modelo de tres meses. Boson AI también lo llama “Higgs TTS 3”; es el mismo modelo de 4B.
Su argumento es la cobertura de idiomas y, a diferencia de casi todas las afirmaciones de este tipo, viene con cifras. La ficha del modelo etiqueta 100 idiomas, Boson evaluó 111, y publican un WER/CER de un solo dígito en todo el conjunto: 1.11 de WER en SeedTTS (2 idiomas), 2.74 en MiniMax-Multilingual (32), 3.61 en su propio benchmark de 111 idiomas. Unos 85 de ellos superan el umbral de <5% de WER que consideran calidad de producción. Ningún otro modelo de esta lista publica una tabla multilingüe tan amplia.
El control va en línea y a mitad de frase: 21 etiquetas de emoción, estilos que incluyen cantar, gritar y susurrar, efectos de sonido, además de marcadores de velocidad, tono y pausa. Clonación zero-shot a partir de un clip de referencia y contexto de 8k tokens.
La licencia sigue el patrón ya conocido: el código es Apache 2.0, los pesos están bajo la Boson Higgs TTS 3 Research and Non-Commercial License, y cualquier cosa que genere ingresos necesita un acuerdo aparte. La lista de usos prohibidos de Boson es más concreta que la mayoría: clonar sin consentimiento, suplantación de identidad, fraude, engaño electoral, vigilancia biométrica. La API alojada está en preview pública gratuita, así que puedes evaluarlo sin GPU.
Dos carencias. Boson no publica ninguna cifra de VRAM en ningún canal oficial, lo que para un modelo de 4B probablemente signifique 12-16GB, pero tendrás que medirlo tú. Y para servirlo necesitas SGLang-Omni o la API de Boson, no vLLM-Omni, aunque SGLang-Omni tuvo soporte desde el primer día y publica cifras de rendimiento: ~15 peticiones/segundo con RTF 0.26 en una sola H100.
Especificaciones clave
- Arquitectura: 4B, backbone multimodal basado en Qwen3, contexto de 8k
- Licencia: código Apache 2.0, pesos bajo la Boson Higgs TTS 3 Research and Non-Commercial License
- Lanzamiento: 4 de junio de 2026
- Idiomas: más de 100 etiquetados, 111 evaluados, ~85 con <5% de WER
- Elo en Speech Arena: 1,042 provider-voice / 958 controlled-voice
- Self-hosting: SGLang-Omni; sin mínimo de VRAM publicado
9. Chatterbox (Resemble AI) - MIT, 23 idiomas y exageración emocional
Chatterbox consigue 1,020 Elo y es la opción con licencia permisiva más completa: MIT, 0.5B parámetros, clonación a partir de ~5 segundos de audio y un control de exageración emocional que, según Resemble, fue el primero en el mundo open source. Con 26k estrellas en GitHub y 1.8 millones de descargas, es el modelo más popular de la clasificación después de Kokoro, y el repo sigue activo (último commit en julio de 2026).
La familia ha crecido mucho desde la versión original en inglés de mayo de 2025: Multilingual (septiembre de 2025) cubre 23 idiomas, y v3 (junio de 2026) llega a ~25 con 6 paquetes ajustados para un solo idioma. Chatterbox Turbo es el que toca para trabajo en tiempo real: 350M parámetros, 75ms de latencia, ~6x tiempo real gracias a un decodificador mel de un solo paso, además de etiquetas paralingüísticas ([laugh], [sigh], [whisper]).
Resemble publica tasas de victoria en evaluaciones a ciegas y, cosa que se agradece, también las derrotas: Turbo gana a ElevenLabs Turbo v2.5 un 65.3% de las veces y a VibeVoice 7B un 59.1%, pero empata con Cartesia Sonic 3 al 49.8%. Eso le da más credibilidad de la que se gana la mayoría de tablas de fabricantes.
Algo a tener en cuenta: toda salida de Chatterbox lleva marca de agua neuronal PerTh, incrustada durante la generación. Es una ventaja si te importa la procedencia, y una limitación si no quieres una señal inaudible en tu audio. No hay cifra oficial de VRAM.
Especificaciones clave
- Arquitectura: backbone de 0.5B estilo Llama, entrenado con ~500k horas
- Licencia: MIT
- Lanzamiento: mayo de 2025 (inglés), septiembre de 2025 (multilingüe), junio de 2026 (v3)
- Idiomas: 23 (multilingüe), ~25 en v3
- Elo en Speech Arena: 1,020 provider-voice / 927 controlled-voice
- Self-hosting:
pip install chatterbox-tts; ~200ms de latencia, Turbo a 75ms; sin mínimo de VRAM publicado
10. Zonos-v0.1 (Zyphra) - Apache 2.0, 44kHz, funciona con 6GB
Zonos-v0.1 (10 de febrero de 2025) está exactamente en 1,000 Elo y sigue siendo un caballo de batalla sólido con Apache 2.0, sobre todo porque es el modelo con clonación que menos VRAM pide de esta lista. Zyphra publicó dos variantes de 1.6B, un transformer puro y un híbrido SSM basado en Mamba2, entrenadas con ~200k horas y con salida nativa a 44kHz. Tuvo la corona de la frecuencia de muestreo hasta que VoxCPM2 llegó con 48kHz en abril de 2026, que ahora es mejor opción si la fidelidad es el motivo por el que mirabas Zonos.
Clona a partir de una muestra de 10-30 segundos con controles de condicionamiento para velocidad de habla, tono, frecuencia máxima y emoción, funciona con 6GB+ de VRAM con una interfaz Gradio y Docker, y alcanza aproximadamente 2x tiempo real en una 4090. La variante híbrida necesita una RTX serie 3000 o más reciente.
Dos pegas, siendo sinceros. Zyphra no publica ningún benchmark cuantitativo, y reconoce en el anuncio que la calidad de audio es difícil de cuantificar. Y dieciocho meses después sigue etiquetado como v0.1 beta; los datos de entrenamiento incluyen idiomas más allá del inglés, japonés, chino, francés y alemán, pero no funcionan de forma fiable.
Especificaciones clave
- Arquitectura: transformer de 1.6B o híbrido SSM Mamba2 de 1.6B, salida a 44kHz
- Licencia: Apache 2.0
- Lanzamiento: 10 de febrero de 2025
- Idiomas: inglés, japonés, chino, francés, alemán (los demás, poco fiables)
- Elo en Speech Arena: 1,000
- Self-hosting: 6GB+ de VRAM; el híbrido necesita una RTX serie 3000 o más reciente; ~2x tiempo real en una 4090
Modelos abiertos sólidos que el Speech Arena no ha puntuado
La tabla de Elo de arriba es la mejor señal en TTS, pero no es un censo. Artificial Analysis añade un modelo cuando hay un endpoint que probar y suficientes votos para clasificarlo, y tres buenos modelos de pesos abiertos se han colado por ese hueco. Dos de ellos son Apache 2.0, y como los dos primeros de la tabla son no comerciales, eso los convierte en las omisiones más importantes de esta guía.
Trata esta sección de otra manera: son cifras que da el propio fabricante, no pruebas de escucha a ciegas, así que tómalas con cautela. Pero 3 millones de descargas son una señal en sí mismas.
Qwen3-TTS - Apache 2.0, y el modelo más descargado que no es Kokoro
Qwen3-TTS (Alibaba, 22 de enero de 2026) es uno de los dos modelos que la gente de verdad está ejecutando. El checkpoint base de 1.7B tiene 3.0 millones de descargas en Hugging Face y la variante CustomVoice otros 2.4 millones, muy por encima de cualquier modelo de la clasificación salvo Kokoro y Chatterbox, y es el TTS por defecto del pipeline speech-to-speech de Hugging Face. Tanto los pesos como los tokenizadores son Apache 2.0.
Se distribuye como una matriz y no como un único modelo: tamaños de 0.6B y 1.7B, cada uno en versiones Base, CustomVoice y VoiceDesign. La descarga base de 1.7B ocupa 4.54GB, y la de 0.6B, 2.52GB. Diez idiomas, entrenado con más de 5 millones de horas de voz, 50 veces el conjunto de GLM-TTS, lo que probablemente explica su solidez multilingüe.
Las afirmaciones de Alibaba son lo bastante concretas como para comprobarlas: el WER más bajo en el benchmark de clonación zero-shot de Seed-TTS, con mejor similitud de locutor que MiniMax y ElevenLabs en los 10 idiomas, y, para VoiceDesign, estado del arte en InstructTTSEval por delante de Hume y VoiceSculptor. vLLM-Omni sirve directamente las cinco variantes y LocalAI tiene un backend para él.
La carencia es la que importa: no tiene puntuación de escucha a ciegas, así que no puedes compararlo con Breeze o Fish. El repo, además, lleva sin movimiento desde marzo de 2026, aunque para un modelo tan desplegado eso suena más a “terminado” que a “abandonado”.
VoxCPM2 - Apache 2.0, 30 idiomas, 48kHz, y funciona en una CPU
VoxCPM2 (OpenBMB, abril de 2026, Apache 2.0) es el que deberías mirar si la sección de licencias de más abajo te preocupa. Es un modelo de 2B que cubre 30 idiomas más nueve dialectos chinos, y genera audio a 48kHz (la frecuencia de muestreo más alta de esta guía, por encima de los 44kHz de Zonos) a partir de un clip de referencia de 16kHz.
En arquitectura es el bicho raro: sin tokenizador, un modelo autorregresivo de difusión que trabaja en el espacio latente de AudioVAE V2. En la práctica, te da tres modos de clonación con una curva de compromiso honesta: Voice Design solo a partir de una descripción escrita, Controllable Cloning con audio de referencia más indicaciones de estilo, y Ultimate Cloning, que además pide una transcripción y conserva el mayor detalle. Consigue 1.84% de WER en Seed-TTS-eval en inglés y 0.97% de CER en el conjunto difícil en chino, con unos 8GB de VRAM y RTF ~0.30 en una 4090.
En despliegue es el mejor de toda la lista. Además de PyTorch y vLLM-Omni, está llama.cpp-omni, que lo ejecuta desde pesos GGUF en CPU, Metal, CUDA o Vulkan sin PyTorch en ninguna parte del stack. Kokoro ha sido la única opción real en CPU en este terreno durante un año; este es el primer modelo serio que se le une, con 24 veces más parámetros y 30 idiomas.
Es además el modelo con el desarrollo más activo de esta guía: 36k estrellas en GitHub, 311k descargas y commits en la última semana.
GLM-TTS - el clonador de Zhipu ajustado con RL, con licencia permisiva
GLM-TTS (Zhipu AI / zai-org, liberado en diciembre de 2025) es la apuesta TTS de la familia GLM, y resulta interesante por cómo se entrenó más que por lo que puntúa.
La arquitectura es la habitual en 2026: un LLM basado en Llama convierte el texto en tokens de voz, un modelo de flow matching los convierte en un espectrograma mel y un vocoder genera la forma de onda. Lo inusual es el post-entrenamiento. Zhipu aplicó aprendizaje por refuerzo con múltiples recompensas mediante GRPO con cuatro funciones de recompensa (similitud de locutor, tasa de error de caracteres, emoción y risa), una técnica estándar en los LLM abiertos y casi inédita en el TTS abierto. Funciona: en seed-tts-eval en chino, el checkpoint con RL obtiene 0.89 de CER y 76.4 de similitud de locutor frente a 1.03 y 76.1 sin RL, con solo ~100k horas de audio de entrenamiento.
Clona a partir de 3 a 10 segundos de audio de prompt, acepta entrada híbrida de fonemas más texto para controlar la pronunciación, hace streaming y funciona en NPUs Ascend 910B además de en CUDA.
Dos cosas que debes saber. La licencia es permisiva, pero se indica de forma inconsistente: el repo de GitHub dice Apache 2.0 y la ficha del modelo en Hugging Face dice MIT. En cualquier caso, puedes usarlo en un producto. Y funciona solo en chino e inglés, sin cifra de VRAM publicada, y el repo está parado desde abril de 2026: 1,055 estrellas frente a las 36,000 de VoxCPM2 te dicen hacia dónde se fue la comunidad.
No existe ningún modelo TTS de DeepSeek
Conviene decirlo claramente, porque es una búsqueda habitual y la respuesta es no. DeepSeek nunca ha publicado un modelo de texto a voz. DeepSeek V4 (24 de abril de 2026, licencia MIT, variantes Pro de 1.6T parámetros y Flash de 284B) es solo de texto. DeepSeek dice qeu lo multimodal está en desarrollo, sin fecha publicada.
Si buscabas un modelo TTS abierto de un laboratorio chino, los que existen son Qwen3-TTS y GLM-TTS, más arriba, además de Fish Audio S2 Pro y Step Audio EditX en la clasificación. Si quieres V4 para el texto y una voz encima, combínalo con Kokoro o Qwen3-TTS detrás del mismo servidor compatible con OpenAI.
Historia y callejones sin salida
Dos cosas que conviene saber antes de ir de compras por la mitad inferior de la clasificación.
VibeVoice 7B - el que Microsoft retiró
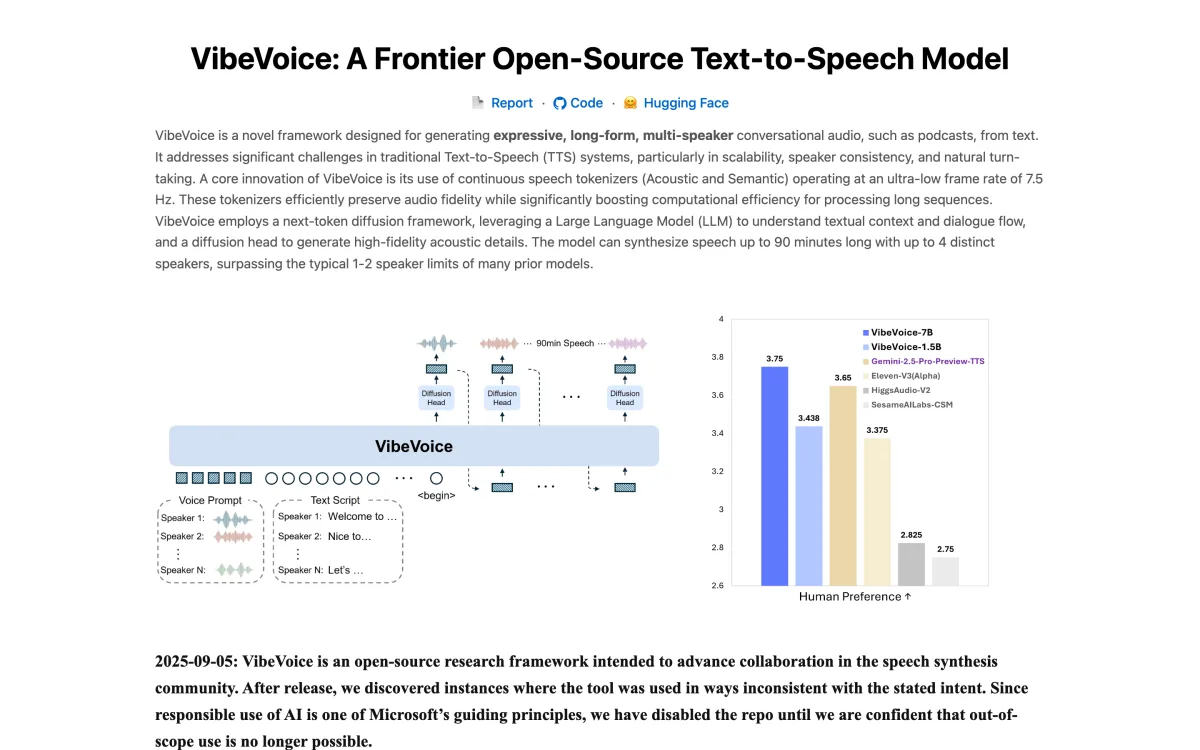
Microsoft publicó VibeVoice-7B-Preview el 26 de agosto de 2025: un modelo de difusión next-token capaz de generar 90 minutos de audio con 4 locutores distintos, muy por encima de todo lo demás en ese momento. Diez días después lo retiró, alegando un uso “incompatible con la intención declarada”, y eliminó los pesos y el código TTS de sus repos.
No sirvió de nada. El modelo tenía licencia MIT, así que los mirrors de la comunidad son totalmente legales y siguen disponibles. Microsoft retiró un modelo que ya había regalado con una licencia que dice que no puedes echarte atrás, y un año después su 969 Elo se sigue calculando con pesos que Microsoft ya no distribuye.
Una trampa si te pones a buscarlo: la gama actual de Microsoft incluye VibeVoice-ASR (9B), que es reconocimiento de voz, no TTS. Si buscas “VibeVoice 7B” es fácil acabar ahí. El “7B” del nombre original era el backbone LLM; el modelo completo tenía ~9B.
Cuatro modelos que puedes saltarte
La parte baja de la clasificación es un cementerio. Ninguno de estos repos está archivado, así que tienes que mirar las fechas de los commits en lugar de fiarte de la etiqueta de archivado.
- OpenVoice v2 (MIT, 954 Elo) - sigue siendo el único modelo con un conversor de timbre desacoplado, así que puedes clonar en cualquier idioma y hablar en seis. Pero la calidad está limitada por su locutor base de MeloTTS, y las dos capas están paradas desde 2025.
- XTTS v2 (920 Elo) - la mayor cobertura de idiomas de esta lista, con 17, y clonación a partir de ~3 segundos. Su licencia es un lío, que explicamos en la siguiente sección. Si lo usas, usa el fork de Idiap.
- StyleTTS 2 (892 Elo) - importa como antepasado: Kokoro está construido directamente sobre él. Sus propios pesos son solo en inglés y la licencia es más turbia de lo que sugiere la etiqueta “MIT”.
- MetaVoice v1 (Apache 2.0, 844 Elo) - sáltatelo. Kokoro te da Apache 2.0 con 82M, mejor resultado y una sexta parte de la VRAM. Último commit en julio de 2024.
“Pesos abiertos” y “código abierto” no son lo mismo aquí
Lee la licencia, no la landing page. El TTS es peor en esto que el mundo de los LLM, y empeoró de forma medible durante el verano: los dos primeros modelos de la tabla son no comerciales, y el #8 también. En julio, el #1 era Apache 2.0 y podíamos decirte que la restricción no dolía. Ya no es así.
La página de producto de Fish Audio para S2 Pro dice “La IA de voz más expresiva jamás creada, ahora open source.” Los pesos se distribuyen bajo la Fish Audio Research License, que es no comercial. Voxtral TTS de Mistral es CC BY-NC 4.0. Los dos se pueden descargar y ejecutar de verdad en tu propio hardware; ninguno es open source en el sentido de la OSI, y ninguno puede ir en un producto comercial sin un acuerdo aparte.
Merece la pena aprender a detectar el truco más reciente. Breeze TTS 2 y Higgs Audio V3 publican su código de inferencia bajo Apache 2.0 y sus pesos bajo una licencia propia de investigación y uso no comercial. La barra lateral de GitHub dice “Apache-2.0” en ambos repos, Hugging Face dice license: other, y un vistazo rápido al repo te llevará a la conclusión equivocada. La licencia que te obliga es la de los pesos, y tienes que abrir la ficha del modelo para encontrarla.
El caso que sirve de advertencia es XTTS v2. Su código es MPL-2.0, pero sus pesos están bajo la Coqui Public Model License, que permite “solo el uso no comercial de un modelo de machine learning y de sus resultados”, y Coqui, la empresa, cerró en enero de 2024 sin responder a una petición para cambiarles la licencia. Los pesos son ahora no comerciales para siempre, sin nadie que pueda venderte una licencia comercial; la URL canónica de la licencia en coqui.ai/cpml da un 404. El fork de Idiap mantiene vivo el código (paquete pip coqui-tts), pero un fork no puede cambiar la licencia de unos pesos que no entrenó. El repo original, ya muerto, tiene ~45k estrellas frente a las ~2k del fork activo, así que los resultados de búsqueda te mandarán al cadáver.
Si necesitas uso comercial, las opciones seguras son Step Audio EditX (Apache 2.0), Qwen3-TTS (Apache 2.0), VoxCPM2 (Apache 2.0), Kokoro (Apache 2.0), Maya1 (Apache 2.0), GLM-TTS (pesos MIT), Chatterbox (MIT), Zonos (Apache 2.0) y NVIDIA Magpie (NVIDIA Open Model License, que sí permite el uso comercial).
Esa lista es más larga de lo que parece viendo la clasificación, y ese es el motivo práctico de que exista la sección anterior. El mejor modelo que puedes usar legalmente en un producto es Step Audio EditX, con 1,102 Elo, a 113 puntos de la cima, pero Qwen3-TTS y VoxCPM2 no están clasificados, son permisivos, acumulan muchísimas descargas y muy posiblemente sean mejores. Evalúa tú mismo esos dos en lugar de ir bajando por la tabla de Elo hasta dar con una licencia con la que puedas vivir.
Cómo alojar estos modelos tú mismo
Esto es lo que nadie dice claramente: todavía no existe un Ollama para TTS. Ollama en sí no tiene ningún soporte de texto a voz: la petición de la funcionalidad lleva abierta desde junio de 2025 sin implementación. Lo que sí se ha estandarizado es la forma de la API (casi todo habla ya el dialecto POST /v1/audio/speech de OpenAI), pero no el runtime. Cada servidor envuelve un subconjunto distinto y reducido de modelos, y ninguno te da la experiencia de Ollama: un solo binario, descargar cualquier modelo, nada de Python.
Lo más cerca que ha llegado alguien es llama.cpp-omni, que ejecuta VoxCPM2 desde GGUF sin nada de Python. Un solo modelo, pero con la forma correcta.
Gran parte del motivo: ninguna biblioteca contiene siquiera los modelos que la gente despliega de verdad. Hugging Face Transformers tiene soporte text-to-waveform para Bark, CSM, Higgs Audio v2, los modelos omni de Qwen, SeamlessM4T y VITS, pero ni Kokoro, ni XTTS, ni Chatterbox, ni F5-TTS. Cada uno de los modelos populares vive en su propio repo con su propia ruta de inferencia.
Los servidores que merece la pena usar
| Herramienta | Ideal para | Modelos cubiertos |
|---|---|---|
| LocalAI | La mayor cobertura, un solo servidor para TTS + LLM + más | Coqui, Piper, Qwen3-TTS, VibeVoice, Chatterbox, fish-speech |
| vLLM-Omni | Servicio en GPU para producción, streaming, batching | Qwen3-TTS (las 5 variantes), fishaudio/s2-pro, Voxtral-4B-TTS, VoxCPM2, CosyVoice3, OmniVoice, MOSS-TTS-Nano |
| llama.cpp-omni | GGUF en CPU, Metal, CUDA o Vulkan, sin PyTorch | Solo VoxCPM2 |
| SGLang-Omni | La única vía para Higgs Audio V3 | Higgs Audio V3, Fish S2 Pro |
| Kokoro-FastAPI | El camino más rápido hacia un endpoint funcionando | Solo Kokoro-82M |
| kokoro-onnx | CPU y edge, sin dependencia de PyTorch | Solo Kokoro-82M |
Con vLLM en concreto, el detalle importa: el vLLM principal no hace TTS; su lista de modelos soportados trata el audio solo como entrada. El texto a voz vive en un subproyecto oficial aparte, vllm-omni, que es donde encontrarás /v1/audio/speech, /v1/audio/voices, endpoints de batch y un endpoint de streaming por WebSocket. Si un tutorial te dice que sirvas Fish S2 Pro o Voxtral TTS desde vLLM a secas, está desactualizado.
Algunas minas más que conviene conocer:
- openedai-speech está archivado y muerto, y uno de los cuatro sucesores que recomienda su README lleva mucho tiempo muerto también. No empieces por aquí.
- Piper cambió de organización.
rhasspy/piperestá archivado; el proyecto activo es OHF-Voice/piper1-gpl. Varios proyectos de servidor siguen enlazando el repo antiguo. - El binario
llama-ttsde llama.cpp upstream es un callejón sin salida: está atado a OuteTTS-0.2-500M, un modelo de 2024. Usa en su lugar el fork llama.cpp-omni y VoxCPM2. - Speaches se presenta como “Ollama, pero para TTS/STT” y es el más parecido en espíritu, pero solo ejecuta Kokoro y Piper y su rama
masterestá parada desde abril de 2026. - Breeze TTS 2 todavía no tiene servidor. El modelo #1 trae una CLI de PyTorch, una API de streaming que atiende una sola petición a la vez y una imagen de Docker. ¿Necesitas batching? Esa capa te la escribes tú.
Para el panorama más amplio del self-hosting, nuestras guías sobre cómo alojar cualquier LLM tú mismo y cómo elegir hardware para modelos locales cubren la base de GPU, cuantización y drivers, que aquí también se aplica.
Cómo llegar a tu servidor TTS desde fuera de tu red
Una vez que tu modelo esté sirviendo en localhost:8880 o donde sea, normalmente querrás acceder a él desde otro sitio: un móvil, una app de staging, un compañero de equipo o un agente de IA que necesita una voz. Un túnel de Pinggy lo resuelve con una sola línea:
ssh -p 443 -R0:localhost:8880 free.pinggy.ioEso imprime una URL HTTPS pública como https://abc123.a.pinggy.link que apunta a tu endpoint local, así que un cliente compatible con OpenAI puede llamar a /v1/audio/speech desde cualquier sitio sin que tengas que abrir un puerto ni configurar un proxy inverso. Lo hemos explicado con más detalle para Voicebox, un estudio de voz con IA que funciona en local, y para Kokoro en una GPU gratuita de Colab.
Guía rápida para decidir
| Lo que necesitas | Modelo recomendado | Por qué |
|---|---|---|
| La mejor calidad, sin más | Breeze TTS 2 | 1,215 Elo, por encima de ElevenLabs Eleven v3, en una tarjeta de 12GB, pero los pesos son no comerciales |
| La mejor calidad que puedes usar en un producto | Step Audio EditX | El modelo Apache 2.0 mejor clasificado, con 1,102; evalúa Qwen3-TTS y VoxCPM2 junto a él |
| Mucho volumen con poco presupuesto | Kokoro 82M | Calidad de top seis con 82M parámetros; funciona en una CPU por el precio de la electricidad |
| Clonar una voz concreta | Voxtral TTS | Gana el Controlled Voice Arena entre los pesos abiertos con una referencia de 3 segundos; Chatterbox si necesitas MIT |
| Dirección emocional fina | Fish Audio S2 Pro o Step Audio EditX | Etiquetas libres en línea frente a edición iterativa en el espacio de tokens |
| Multilingüe y comercial | VoxCPM2 o Chatterbox | 30 y 23 idiomas, Apache 2.0 y MIT respectivamente |
| La mayor cobertura de idiomas | Higgs Audio V3 TTS | Más de 100 idiomas con WER publicado por benchmark; no comercial |
| Una voz sin audio de referencia | Qwen3-TTS VoiceDesign o Maya1 | Describes al locutor con texto, sin problemas de consentimiento que gestionar, ambos Apache 2.0 |
| Agentes de voz, una voz coherente | Magpie-Multilingual 357M | Locutores fijos por diseño, 357M parámetros, seguro para uso comercial |
| La máxima fidelidad de audio | VoxCPM2 | Salida nativa a 48kHz, por encima de los 44kHz de Zonos y los 24kHz del resto |
| Sin GPU | Kokoro o VoxCPM2 | Kokoro con ONNX, VoxCPM2 con GGUF de llama.cpp-omni; ninguno necesita PyTorch |
Conclusión
Este verano los modelos de pesos abiertos alcanzaron a los cerrados. Breeze TTS 2 supera al buque insignia de ElevenLabs de $100 por millón, Voxtral TTS clona una voz mejor que cualquier otra cosa que puedas descargar, y Kokoro sigue haciendo una parte sorprendente de todo eso con 82 millones de parámetros en una CPU. Sonic 3.6 de Cartesia sigue por delante de todos ellos, y si la calidad de voz es el producto que vendes, paga por él, pero eso abarca menos casos de uso de lo que parece.
Tres cosas que hay que hacer bien. Lee la licencia de los pesos, no la landing page: la insignia de GitHub dice Apache 2.0 en modelos que no puedes usar en un producto. No te quedes en la clasificación, porque dos de los mejores modelos con licencia permisiva de esta guía no aparecen en ella. Y reserva tu tiempo para la capa de servicio, no para el modelo: todavía no hay un Ollama para TTS.